再谈抽象
16 年我写过一篇文章,抽象的能力,没有读过的同学可以再看看。那文章算是一个引子,举了不少实战中对代码和对需求进行抽象的小李子。大家重点注意一下最后一个例子 —— feed parser 的抽象。feed 是好莱坞 studio 给我们提供的可供播放的短视频的清单,每家 studio 都有自己的 feed,结构上大同小异,细节上差别不小:格式上,有 xml 和 json 的区别,内容上,同为标题,有的 key 名是 title,有的是 name,同为视频的 url,有的放在顶层,有的缩在内部。之前我接手的时候,那是几十个 php 文件组成的工程,每个 php 文件对应一个 feed 的处理。因为 feed 细节上的各种差异,我很能理解前任的处理方式 —— 这样的差异在代码层级上并不好抽象,况且一个一个的处理 feed 的需求在不同时段到来,工程师在压力面前,往往只能着眼于眼前 —— 和产品出身的少爷少奶奶不同,我们光是活着完成需求就已经竭尽全力了呢。
最近我在升级一个不那么紧急的项目(merlin,见我去年的文章:停下来,歇口气,造轮子)。对于需求的种种思考,让我我回想起那篇文章。我现在愈来愈感到:代码上的对抽象的精益求精,或者说实现细节这个层次的抽象,固然非常重要,但对需求的抽象才是王道。前者是术,后者是道。二者的关系大家可以类比参考 agile manifesto。
同一个需求,有的人看到的是一颗星星,有的人看到星星背后的漫天银河。同一个程序员对二者的实现,有云泥之别 —— 不仅代码更加清晰,适用于更大的问题场景,写起来也更加心旷神怡。就像 feed 的处理,一个个吭哧吭哧写,是无聊透顶的重复劳动,而将其抽象出一个描述如何从 feed 中获取需要的信息的「语言」,进而处理这门「语言」的解释和执行,实现这样的需求,想想就如沐春风,战斗力满满。
今天我们延续这个关于抽象的讨论,探索一下怎样从需求层面更好地抽象问题。我会先就着过去一周我对于升级 merlin 的需求的思考过程,然后再将这些思维的活动抽象出来,总结一下。
升级 merlin 的思考经历
merlin 是 Tubi TV 内部的一个 release 构建工具。在造轮子那篇文章里我已经提到了为什么会有这个需求。自那时起,merlin 为我们内部的几个 elixir service 的 release 保驾护航几个月,总体表现不错。然而,当时在需求和设计上的一些缺陷,导致这款产品有这些问题:
- 太依赖 github release —— 如果不生成新的 release,就无法自动构建。这对依赖 staging 进行集成测试的服务不友好。使用者需要在 pull request 里升级版本(才能生成一个 build)。因此,多个开发者间需要在 pull request 中把版本错开,很不方便。开发频繁的时候,我们一天的 patch version(SemVar 里第三位),五个十个地狂跳,比旧金山 TaxiCab 的计价器跳动还要可怕。
- merlin 使用的两台机器都是 t2.medium,一次 release build(还包括一次 release upgrade build)花费十来分钟。当构建繁忙的时候,在队列后面的请求要很久才能排到(Latency 不友好)。
所以我想在下一个版本中,将这些问题解决。初步的考虑是,当构建请求来临时,启动一个强大的 spot instance,处理构建任务,构建完成并上传 S3 后,spot instance 自尽。构建请求可以是来自 github release message(兼容上一版本),也可以是 API —— 进而,我们可以制作 CLI 工具,让用户在 shell 下对任意 git commit 触发构建。有了粗浅的想法后,我们理一理需求:
- 用户(包括 github)可以通过 API 触发构建
- 构建被触发后,启动一个 spot instance(或 ECS fargate,不过 spot instance 实在太便宜了,如 C5.large $0.03/hour,所以 ECS 没有啥价格优势)
- spot instance 基于一个 prebuild 的 AMI(如果 ECS,则 docker)启动,AMI 里包含处理构建的软件。这样启动起来之后,就能自动处理构建任务
- 描述构建任务的 metadata 放置于 spot instance 启动时的 user data 中,构建软件通过
http://169.254.169.254/latest/user-data访问之 - 构建过程中可能要发送一些 telemetry 到 merlin
- 构建完成,把状态和构建的信息(比如 tarball 在哪里)发回给 merlin,然后自尽
这个需求算是比较清晰,实现起来也没有什么难点,无非就是时间问题 —— 对于像我们这样的 startup 来说,它是可以立即撸起袖子干活,逢山开路遇水填桥的那种活儿。
merlin 之前的坑是我埋的,这个业务即不性感,也不紧急;backend 的队友们都扑在一些 visibility 高的,光是名字听起来就热血沸腾的项目上,腾不出手,且我也不舍得就这么浪费他们的时间 —— 所以我只能 eat my own dogshit。我这人白天瞎忙,晚上躲懒 —— 除非有什么能戳到 G 点让我不吃不喝不睡觉也要搞的创意,否则像 merlin 这种一眼就从头看到脚,没有太多挑战的项目,激发不出我的小宇宙。于是需求定下,反正也不着急,我就懒懒地,有一搭没一搭地在脑海中想着。
事实证明,这种懒散,而非全力以赴,促成了我更多,更深的思考,也让 merlin 这个项目首先要解决的问题不断迁移。
在上面的需求中,merlin 由一个服务被拆成了两个部分:control plane 和 data plane(请饶恕一个曾经的网络工程师对区分路径的这种骨子里的执着)。简单来说,control plane 负责派活,是个 scheduler,类似于老鸨;data plane 负责干活,是一堆 resource,就好像苏小小,柳如是,李师师们。而一个个构建任务,是要完成的 task,就是赵佶,柳永,阮郁等的不期而至。
把 merlin 的需求稍稍泛化一下:
- 调用者可以通过 API 触发一个 task
- Control plane 接到 task 后,分配到 data plane 上的某个 resource 上执行
- data plane 向 control plane 汇总 telemetry
- data plane 完成 task 之后,向 control plane 汇报结果,进入到 idle 状态等待下次调度
这样,merlin 就是这泛化后的需求上的一个特殊实现。我在 代码命名:僧敲月下门 一文中谈到了 pipe,stream,flow 这样的用生活中的场景来类比所取的名字的精妙之处,那么我们也把这泛化后的需求的各个部分形象化一下。上面的比喻虽然贴切但不好展开,我们换个比喻:
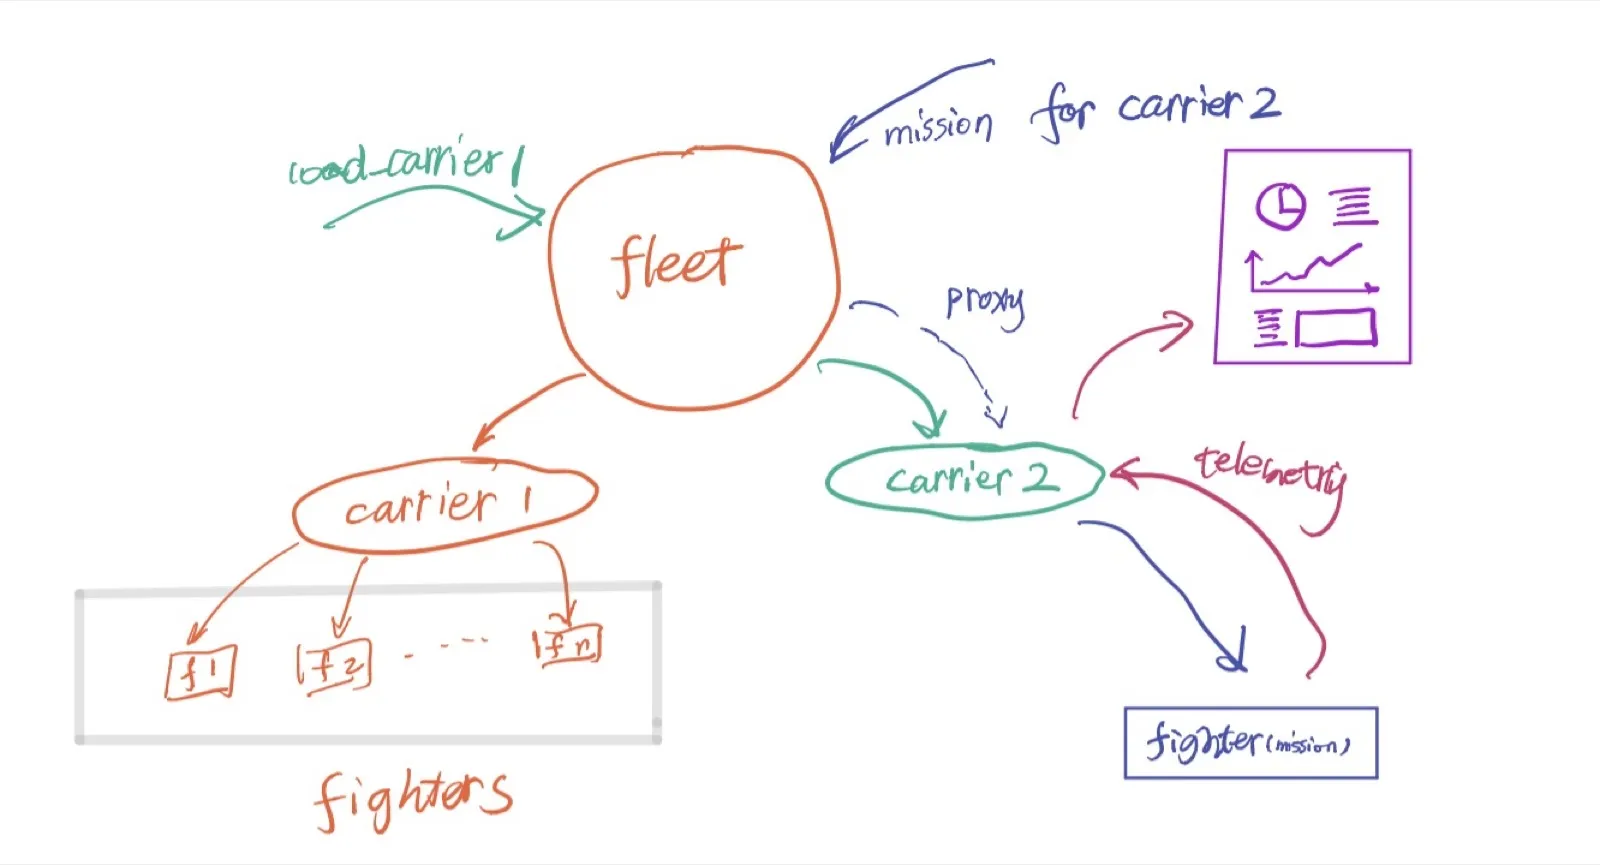
在这个设计中,我把 scheduler 称为 Carrier(航空母舰),resource 称为 Fighter(舰载战斗机),task 称为 Mission(任务),而若干个 Carrier 组成一个 Fleet(舰队)。下面是我坐火车时,关于 Fleet 的一些随性的想法:
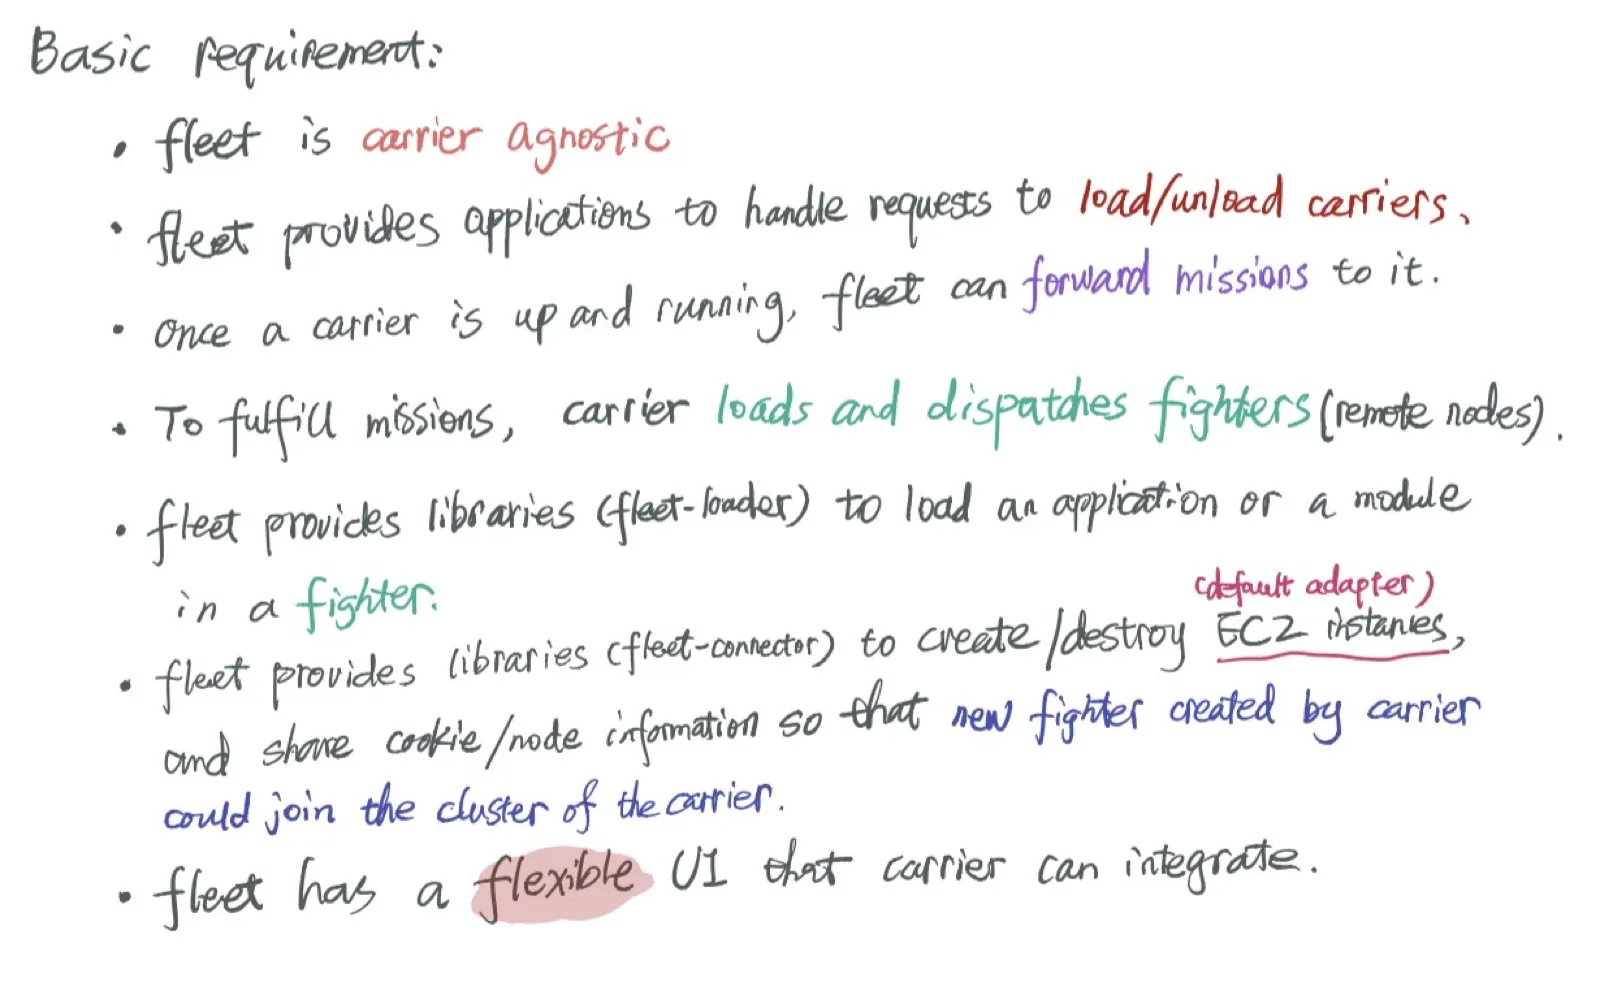
以及围绕着这个想法的进一步思考:
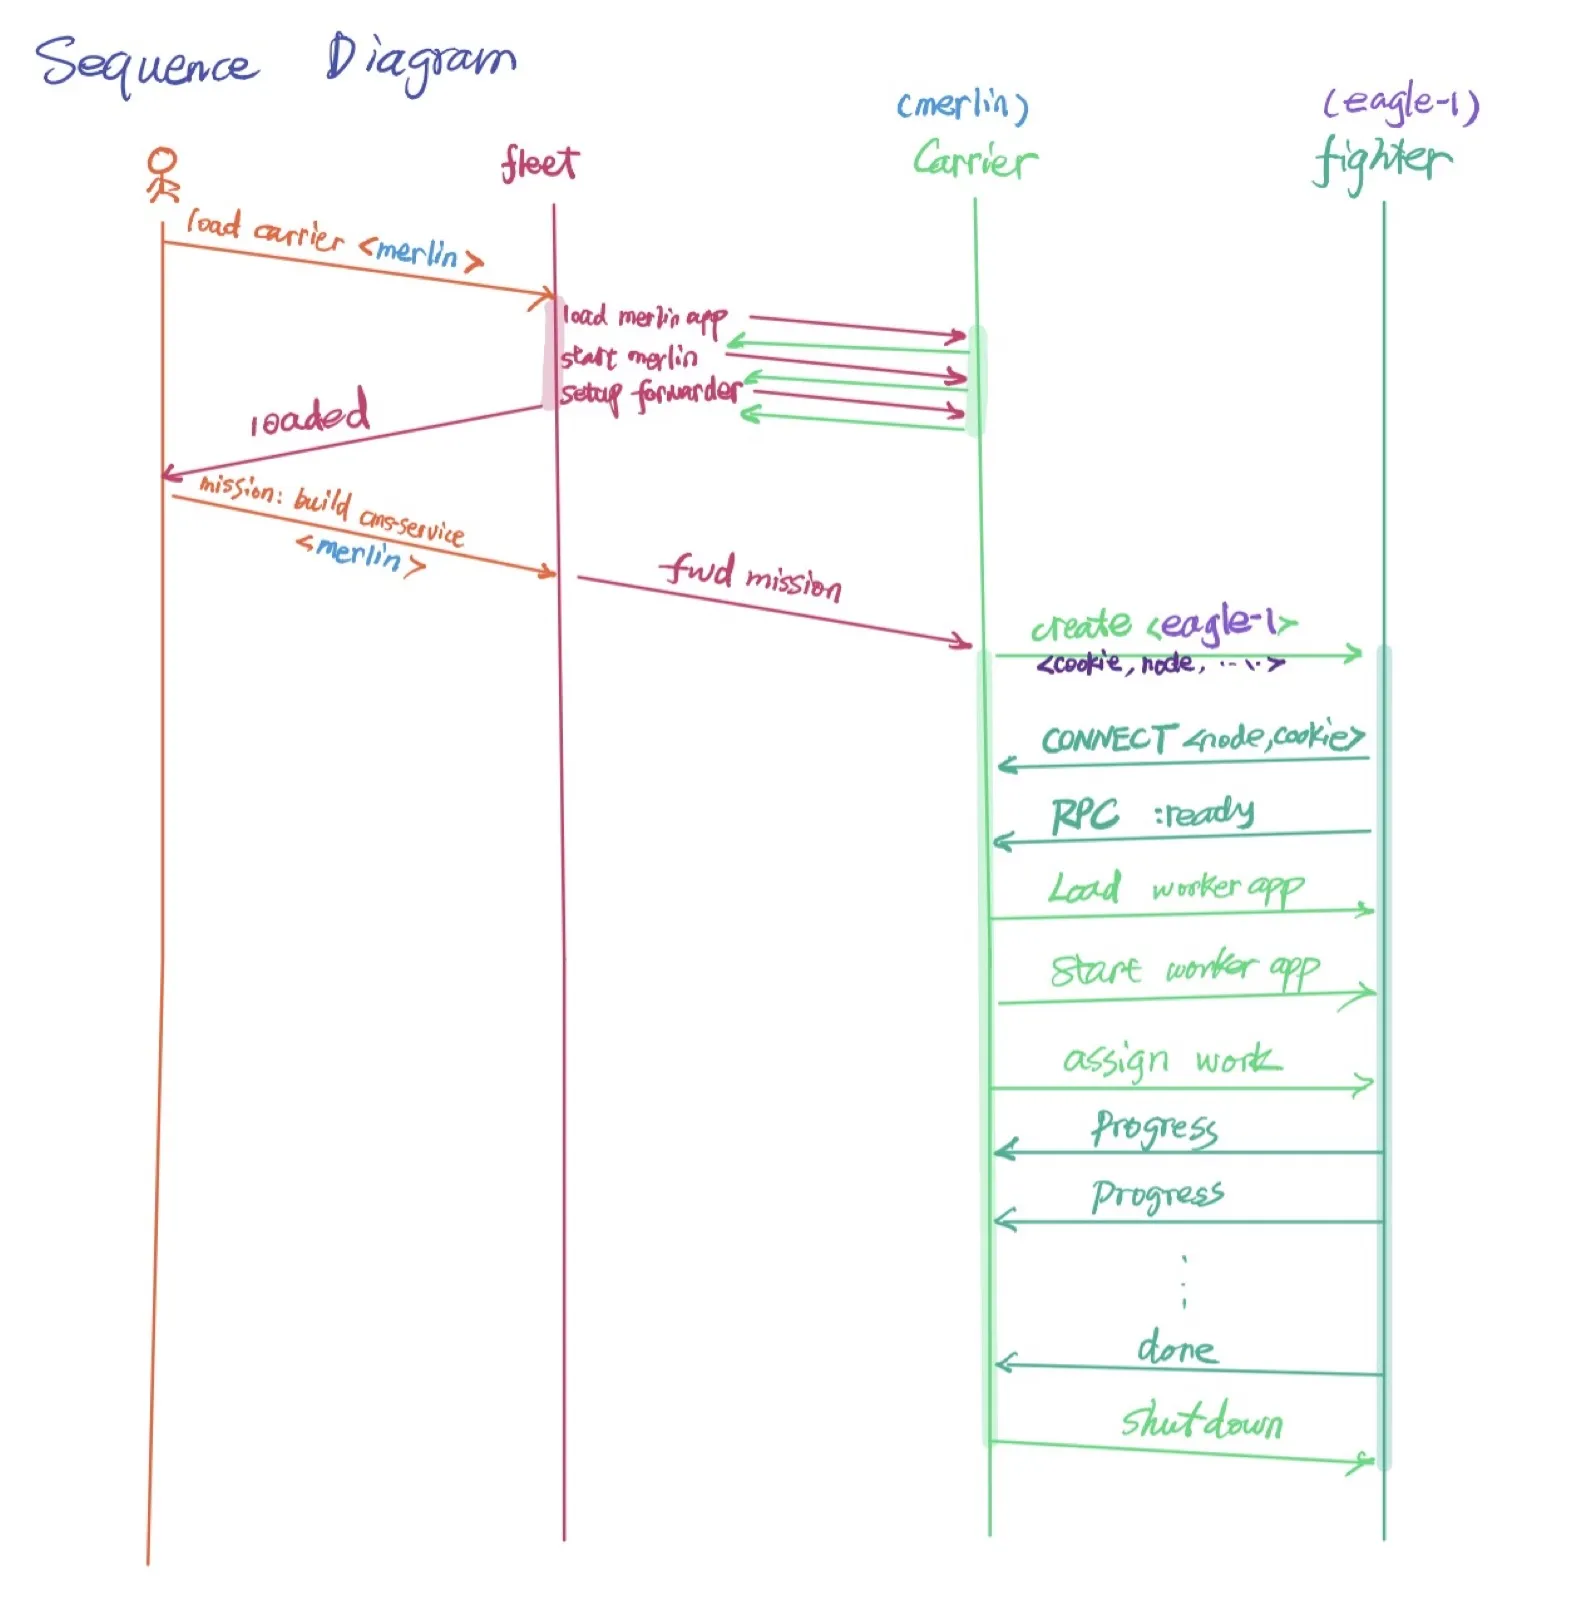
需求自 merlin 起,终于 fleet。merlin 从之前的一个单独的系统,变为 fleet 这样一个宏大构架下的一个应用。这个架构提供运行 control plane 和 data plane 代码的基础组件,使得有类似 merlin 需求的应用,只需要聚焦于业务逻辑,而不用关心 control plane 和 data plane 的组织。至于 fleet 具体的实现,我会撰文另行描述。
现在我们有了一个较为粗糙的 fleet 的需求,我们套上 merlin 的日常业务,根据上面的 sequential diagram 来脑补(dry run)一下系统运行的具体过程:
- 在 fleet UI 上,load carrier merlin。merlin 需要有两套代码,一个是 carrier 的 release tarball,一个是 worker 的 release tarball。
- fleet 在本机(也可以远程)启动一个 erlang node,把 merlin carrier 的 tarball 部署上去。本机的 fleet node 和 merlin carrier node 组成一个 cluster。
- fleet API 自动支持新的 endpoint: htts://fleet.tubi.tv/carriers/merlin/missions。发往这个 endpoint 的请求会被 RPC 到 merlin carrier node。
- 一个新的 mission 发送到了这个 endopint,merlin carrier 收到请求后按照创建时提供的 fighter tarball 及 instance type 启动新的 spot instance:eagle-1。
- eagle-1 的 AMI 里有一份最简单的 bootstrap 代码,启动 erlang node,然后根据 user data 里的 cookie,carrier node 等信息连接 merlin carrier。
- merlin carrier 把 fighter tarball 部署到 eagle-1,然后启动 eagle-1 的 mission。
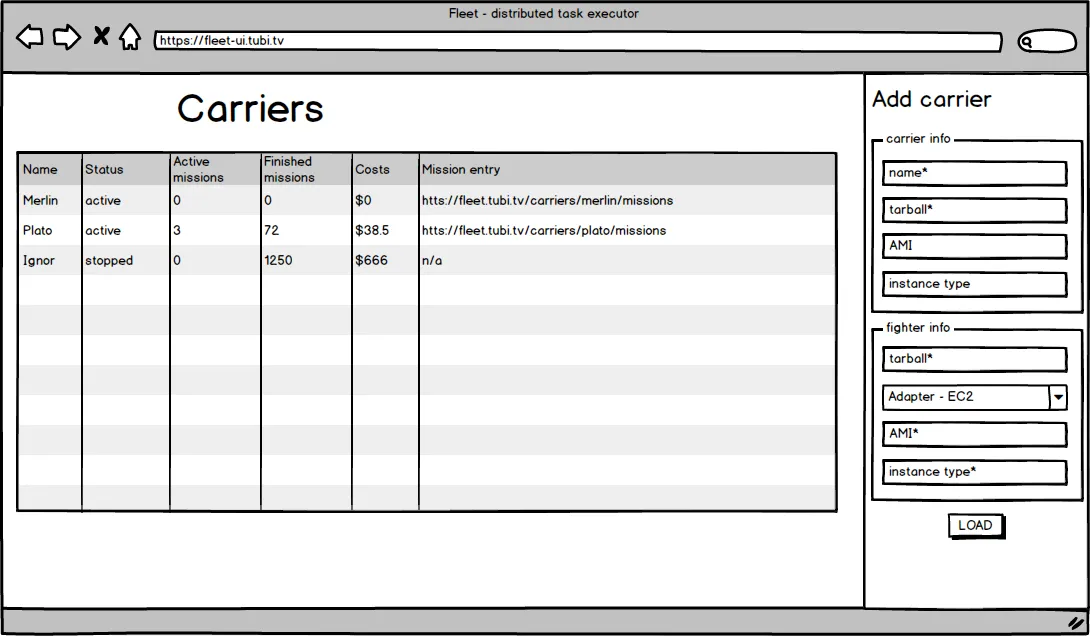
(fleet UI)
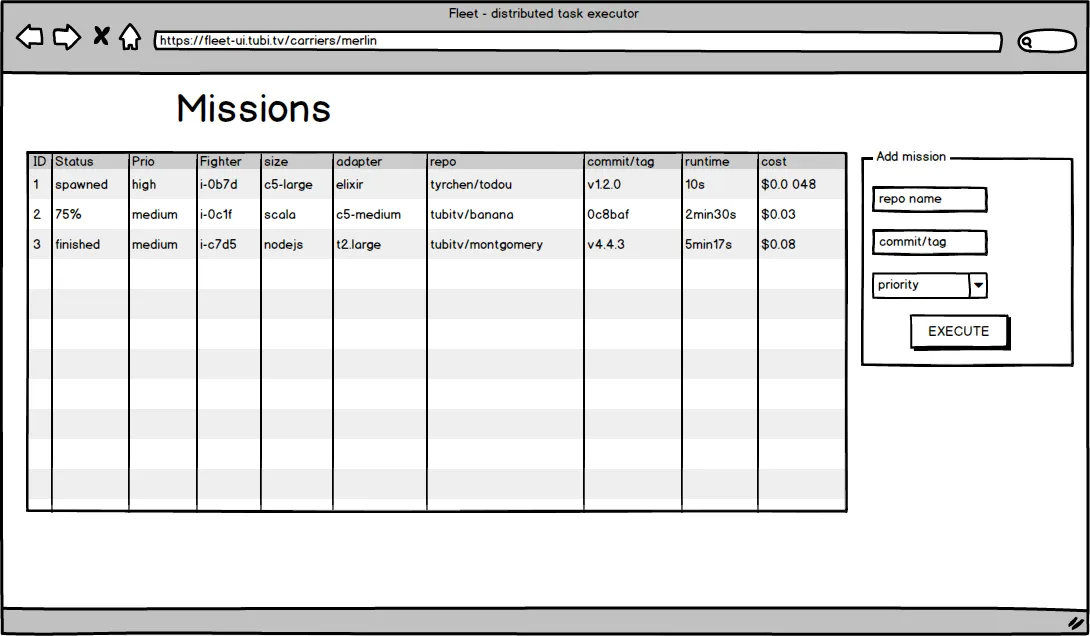
(fleet UI)
一切都说得过去。
接下来我们发现,fleet,carrier 和 fighter 的处理流程中,有些共同的需求:
- fleet 需要启动 carrier,carrier 也需要启动 fighter。
- fleet 需要往 carrier 上动态加载代码,carrier 也需要在 fighter 上动态加载代码。
这两个需求在 fleet basic requirement 那张图里已经有些粗糙的想法,分别对应两个需要拆出来单独处理的 lib:fleet-connector 和 fleet-loader。
顾名思义,fleet-connector 负责启动新的 node,让新 node 加入 cluster 并执行某些工作;fleet-loader 负责在某个已经连接在 cluster 里的 node 里动态加载我们需要的执行代码。
细想下去,fleet-loader 本身跟 fleet 没有什么直接关系和依赖,它广义上可以被重新定义为这样一个需求:node A 把某个本地的 beam,app,甚至 release 加载到远程处在同一个 cluster 下面的 node B 中,确保其正确执行。fleet 只是使用 fleet-loader 的功能而已。所以,我们可以把 fleet-loader decouple 出来,独立成一个和 fleet 无关的 package,叫 ex_loader。
fleet-connector 和 fleet 也没依赖关系。根据上面的描述,我们可以把它和 Supervisor 的功能进行类比:
- Supervisor 根据预置的 MFA(Module,Function,Args)启动新的 process;fleet-connector 根据预置的 ITA(Image,Task,Args)启动新的 node。
- Supervisor 把 supervisor process 和 worker process link 起来,如果 worker process 挂了,supervisor process 用同样的 MFA 重启之;fleet-connector 把 carrier node 和 fighter node link 起来,如果fighter node 挂了, carrier node 用同样的 ITA 重启之。
- Supervisor 支持 one-for-one,rest-for-one,one-for-all,simple-one-for-one 这几种重启策略,fleet-connector 目前只考虑了 simple-one-for-one,但不难扩展。
所以,我们理应把 fleet-connector 独立出来,成为一个单独的 package,为其他应用造福。我管它叫 ex_connector。
ex_loader 的功能很直接,甚至,interface 都可以定义出来:
- ExLoader.load_beam(beam_file, node):把一个 BEAM file 加载到某个远程 node。
- ExLoader.load_apps(tarball, apps, node):把一个 release 里的某个(某些)app 加载到远程 node。
- ExLoader.load_release(tarball, node):把一个 release 全部加载到远程 node。
ex_connector 并没有这么简单,它涉及了 carrier (master) 和 fighter (slave) 两端,很多事件都是异步的,很难用一个 library 来描述。我们知道,在 erlang 里要封装这样的行为,一般用 OTP 里 GenServer 家族的成员,所以它不该叫 ex_connector,应该叫 gen_connector,甚至叫 gen_executor 可能更确切些。作为一个 gen server,它和 user module 的交互如下:
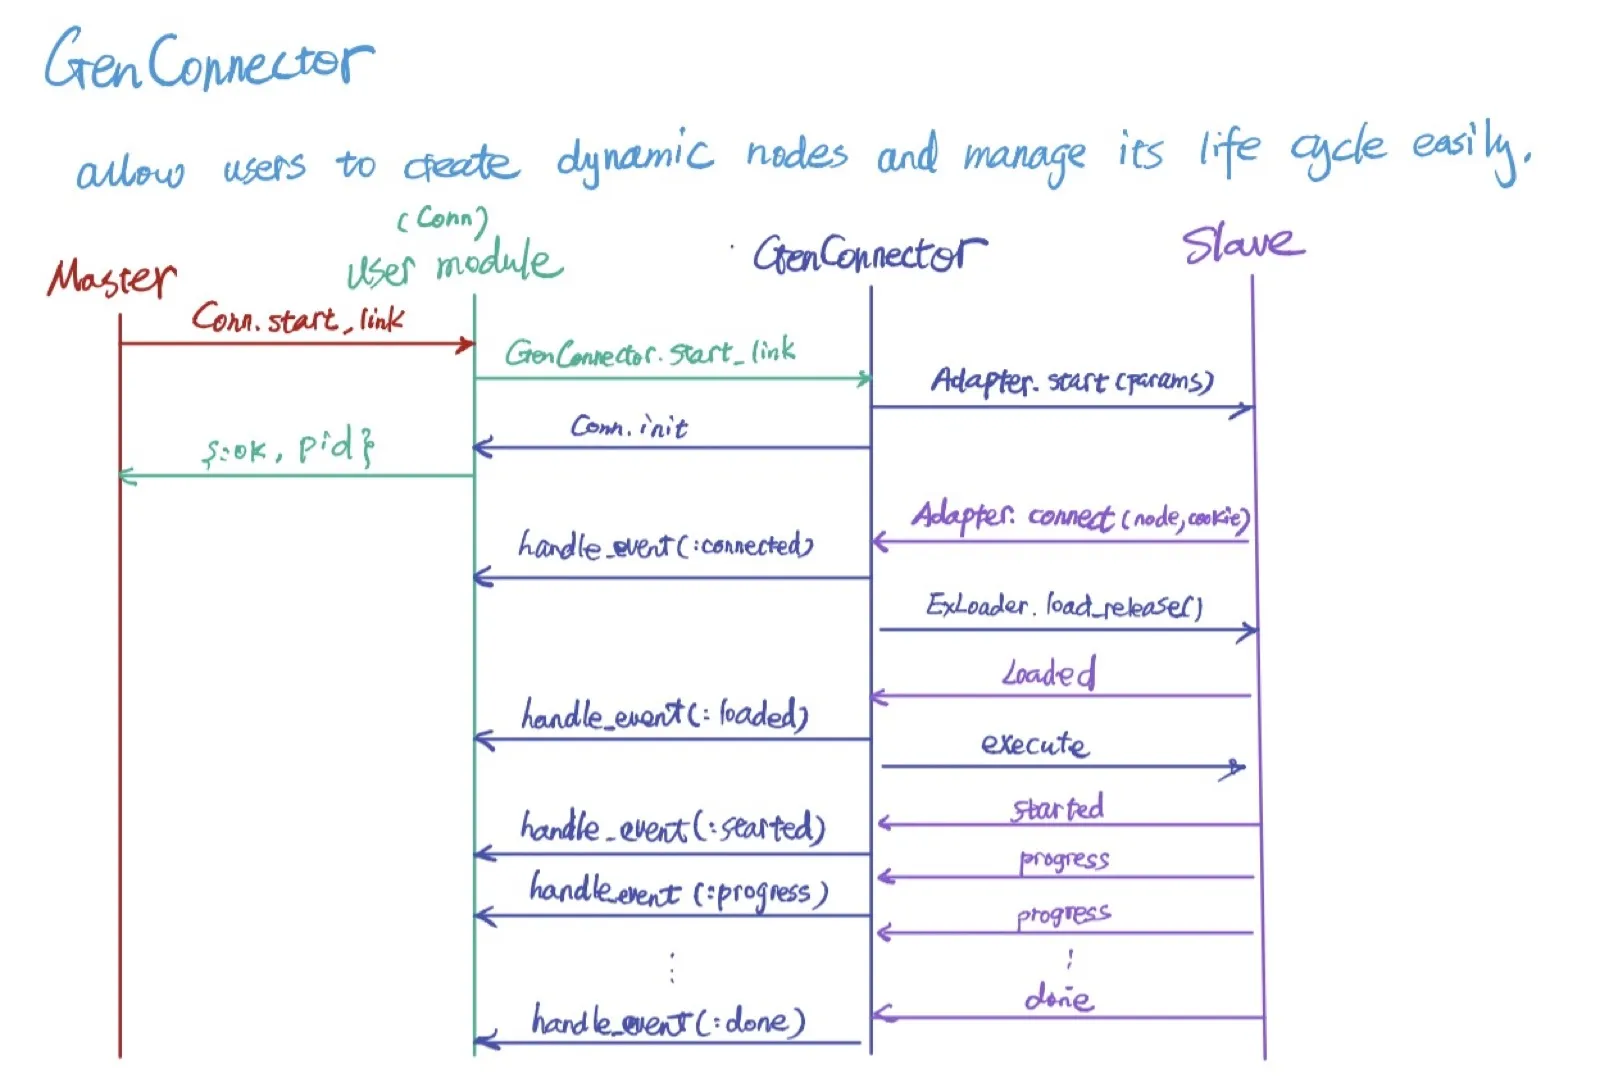
OK,需求被泛化,重组,分解,最后抽象到这个程度,已经差不多了。至少,我们得到了完全和项目初衷无关的 ex_loader 和 gen_connector,不管 merlin 的需求还有什么变化,fleet 还要再怎么泛化,这两个 component 已经可以开工了。
我们稍稍总结一下,一周的懒散和拖延得到了什么样的结果?我们原本是要升级 merlin,让其产生 build 的速度更快(reduce latency),修复一些限制 ,结果,一行代码没写,把一个系统折腾成一个 library,一个 gen server,一个 framework 和一个 app:
- lib: ex_loader
- gen server: gen_connector
- framework: fleet
- app: merlin
且不论这样一整套的东西做下来有多少长期收益,单从抽象的角度来说,我们就获益不少 —— 原本,这些抽象应该发生在做 merlin 和其它系统的过程中,一步步实践出来的 —— 比如,我们做另一个类似 merlin 的任务系统,发现有同样的需求,出于 DRY(Don’t Repeat Yourself)的考虑,拆分 merlin 的代码,把里面和 gen_connector 相关的功能抽取出来,单独组织。进而也许会抽象出 fleet。至于 ex_loader 是否会被抽取出来,全凭运气,我原本考虑, data plane 的 release 整个放在 AMI 里,这样也无不妥,就是 data plane 一有变化,就需要重新构建 AMI 而已。如果是这种设计,那么 ex_loader 完全没有必要,它也不会被创造出来。然而,它们预先被构想出来,因而省却了这中间可能的诸多弯路。
同时,在需求阶段便对其泛化,重组和分解,抽象过程从自下而上变成自上而下,能够大大改善架构和设计,让系统更加适应未来的需求变化。ex_loader / gen_connector / fleet 从 merlin 中拆分出来,成为类似项目的根基这事,对 merlin 本身来说,短期内是负收益;但对这个项目的未来来说,则未必。况且,这三者有额外的收益 —— 如果实现得当,按照预期,它能够大大降低工程师开发和部署分布式环境下进行 control plane / data plane 分离,且 data plane 高度可伸缩的应用。这就好比以太坊打开 ICO 的潘多拉盒子一样,有些复杂的东西,当变得足够简单,便可以把原有的生态系统冲个七零八落。
对抽象过程的抽象
上面拉拉杂杂写了这么多,是为了把我的整个思考的过程原原本本记录下来。我觉得思考的方式,思考的过程,要远比思考之后得出的结论重要。
总结一下,在需求层面抽象,我们要做些什么:
- 对需求不断推敲,加深理解,了解 why,并问 why not;而不是大致清晰之后,撸起袖子开始设计和编码。在这个阶段,脑子里思考,行动上拖沓是有利无害的。Rich Hickey 讲 hammock driven development,大概就是这个意思(建议大家自备梯子去 youtube 仔细看看)。
- 将需求泛化,看看能找到多少通用的部分。寻找生活中和工作中类似的场景,套进去,看能不能自圆其说。这里,类比是必不可少的,它利于我们把经验进行平移。类比的能力是平时需要不断训练的一种能力,你看我的文章,总喜欢将相同的事物放在一起对比。当这种行为成为一种习惯后,你会不自觉地把新事物和你熟知的事物联系起来,找异同。
- 按捺住撸开袖子开干的冲动。在动手之前,先想象自己是需求场景中的一个事件(或者触发器),脑补(dry run)处理的整个流程,一步步推敲。脑子不够用就上手画(保证纸笔或者 pad/pencil 随时都在手边) —— 是的,手绘,而非借助工具,除非工具本身简单到不会影响到你大脑的 flow。你看我讲道理摆事实,把我这周的大部分手稿都贡献出来了。
- 多想几个替代场景。
- 别用大块的时间,别用正儿八经工作的时间去思考 —— 你越认真,就越想不到点子上。跑步的时候想一想,上厕所看程序人生之余,也可以想一想,工作累了想一想,睡前花半小时想一想。对,睡前。不要怕失眠,失眠了起来想一想,困了接着睡。我们要相信念念不忘必有回响 —— 一切的一切就是要激发大脑中那些闲散的异步线程,让它们除了抽烟喝酒烫头之外,还能干点正事。
- 整个思考过程横跨的时间宜长不宜短,太短,不利于建立零零落落的 dots,也无所谓乔帮主所说的 connecting dots;太长,其实倒不打紧,毕竟前有德艺双馨的高老师(Donald Knuth)花了十年写了个 TeX —— 当然前提是你自己(你老板)想得开就可以。一般一两周即可。
- 将所思所想所画文档化,在这个过程中去芜存菁。
谢谢你耐心看到这里。


