是时候认识 jj 了:Git 的下一个进化方向

不破不立,不塞不流,不止不行。—— 韩愈《原道》
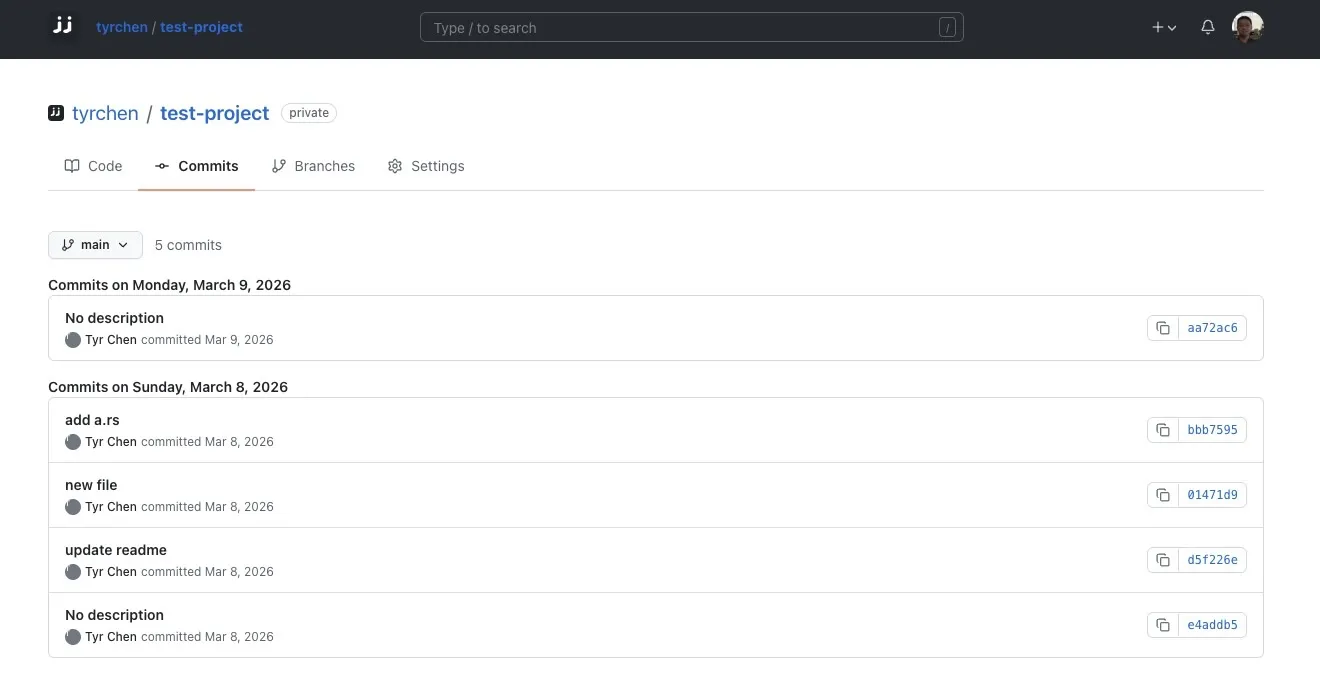
题记:上周末我用 lambda + S3 做了个 Jujutsu(简称 jj)的存储层。这样我自己可以在不依赖于 git 的情况下,在多个设备之间 clone/pull/push jj 项目。
最初我只是好奇:一个 Google 工程师用 Rust 写的版本控制系统,凭什么挑战 Git?用了两天之后,我的感受是:它不是在挑战 Git,它是在替 Git 做进化手术。而且这场手术,对 AI 编程时代尤其关键。
Git 的二十年:伟大,但开始老了
2005 年 Linus Torvalds 写出 Git 的时候,它要解决的问题很明确:Linux 内核需要一个去中心化的、高性能的版本控制系统。Git 漂亮地完成了使命,靠快照存储、轻量级分支和 SHA 哈希寻址,把 Subversion 那一代集中式工具打得毫无还手之力。
二十年过去了,Git 已经是软件工程的基础设施底座。但我们也得承认:Git 的心智模型,对今天的开发者来说太重了。
工作区、暂存区、提交历史,三个状态来回倒腾。忘了 git add 就提交不完整;切个分支被告知“工作区不干净”,被迫 git stash;交互式 rebase 写错一步,代码就找不回来了。这些痛点,用过 Git 的人都懂。
更要命的是,两个大趋势正在动摇 Git 的设计根基:
第一,超大规模单体仓库(Monorepo)成了主流。 Google、Meta、微软,头部大厂都在把千万行代码塞进一个仓库。Git 的全量克隆和基于文件的状态追踪,碰上 TB 级代码库基本就废了。
第二,AI 智能体开始并行写代码。 三五个 AI 代理同时对一个代码库高速读写,Git 那套脆弱的锁机制加上“遇到冲突就全盘阻塞”的设计,根本接不住。
Jujutsu(简称 jj)就是在这个背景下出现的。
jj 是什么:不是换壳,是换引擎
先澄清一个常见误解:jj 不是又一个 Git 的命令行美化工具,不是 Magit,不是 Gitless。它从底层数据模型、并发控制到存储引擎全部重写了。 用 Rust 写的,完全兼容 Git。
说白了,你现有的 .git 目录、GitHub 仓库、CI/CD 流水线,一个都不用动。jj 直接在你的 Git 仓库上跑,产出的提交对象完全符合 Git 格式,任何 Git 客户端都能读。
创始人 Martin von Zweigbergk 是 Google 的资深工程师,2019 年底当个人项目开搞,后来发展成 Google 全职投入的开源项目。今年初 Google 办了首届 JJ Con 开发者大会,jj 早已不是实验品,而是 Google 内部下一代代码协作工具链的核心引擎。
那它到底改了什么?
四个核心重构:从根上治病
消灭暂存区:你的工作区就是一个提交
Git 的暂存区(Staging Area)是无数新手的噩梦,也是老手的日常摩擦源。你得 git add、git commit,有时候还得 git stash,三步走才能完成一个本该一步到位的事。
jj 的做法很激进:直接把暂存区从系统里干掉了。
在 jj 的世界里,你的工作区本身就是一个真实的提交。编辑器里改了文件、保存了,jj 自动把变更记录为提交快照。不需要 add,不需要 stash,不存在“工作区不干净”这种报错。
想切到另一个历史节点?直接切。jj 会在目标节点上创建一个新的工作区提交,你原来的工作一个字都不会丢。
听起来像小改进,实际上是心智模型的降维打击。你不用再在脑子里维护“已修改、已暂存、已提交”这三层状态机了,只剩一个状态:当前提交。 所有能对历史提交做的操作(编辑、合并、rebase),都能直接对你正在写的代码做。
双轨标识:变更 ID 和提交 ID 分离
Git 用 SHA 哈希标识每个提交。问题在于:你 amend 或 rebase 了一个提交,哈希就变了。代码审查时想追踪一个经过五轮修改的补丁,你得靠肉眼去关联前后不同的哈希,在大型项目里这基本不可能。
jj 给每个提交分配了两个标识:
- 提交 ID(Commit ID):十六进制哈希,跟 Git 一样,内容变了就变。
- 变更 ID(Change ID):纯字母序列(比如
kntqzsqt),永远不变。
不管你怎么改提交内容、怎么 rebase、怎么 squash,变更 ID 始终锚定在同一个逻辑工作单元上。代码审查工具可以靠它自动追踪一个特性从创建到合并的全生命周期,再也不会被哈希变化搅乱。
这个设计跟 Gerrit 的 Change ID 如出一辙,但 jj 是从数据模型层面原生支持的,不需要装什么 commit-msg 钩子。
冲突不再是紧急事件,只是一种合法的数据状态
这是我觉得 jj 最精彩的设计。
在 Git 里,合并冲突是一场小型灾难。git rebase 遇到冲突,整个仓库进入“合并中”的阻断状态,不能切分支,不能干别的,必须当场解决那些 <<<<<<< 标记。五层链式 rebase,中间每层都冲突了?那种酸爽,懂的都懂。
jj 的态度是:冲突就冲突呗,天又没塌。
rebase 或合并产生冲突时,jj 不会挂起,不会阻断,而是顺畅地完成操作,把冲突状态记录在提交的内部元数据里。带冲突的提交跟正常提交没有区别,你可以先切到别的任务继续干活,也可以对它再次 rebase,甚至推到远程让队友帮你一起解决。
底层实现上,jj 用了一套代数化的冲突表达。正常提交指向一棵树对象,冲突提交指向一个有序的树对象列表,用 A + (C - B) 这样的代数公式来表达合并状态。冲突提交被再次 rebase 时,系统自动做代数化简,正负项相消,嵌套自动展平,保证冲突表达式永远是最简形态。
这不是小修小补。 “冲突”在版本控制系统里的地位被彻底改写了:从“必须立即处理的紧急状态”变成“可以从容应对的普通数据”。
操作日志:真正的 Ctrl+Z
Git 有 reflog,但它只记录分支引用的移动,覆盖面有限,语法还贼晦涩。
jj 有一个完整的全局操作日志(Operation Log)。你在仓库里做的每一个操作,提交、拉取、推送、rebase、解决冲突,全部被原封不动地记录下来。
想撤销刚才那次涉及几百个提交的 rebase?jj undo,跟按 Ctrl+Z 一样简单。
想回到三天前仓库的状态?jj op restore,整个仓库瞬间穿越回去。
有了这个兜底,你做任何操作都不用怕了。 大胆地重写历史、大胆地实验,搞砸了一个命令就能回来。
日常工作流:少打字,多做事
聊完底层哲学,说说日常手感。
无名分支。 Git 强迫你给每个分支起名字,于是项目里充斥着 fix-bug、test2、tmp-experiment 这种垃圾命名。jj 默认用匿名分支,“书签(Bookmark)“只是个可选的轻量指针。开始新任务?jj new,完事。
堆叠式开发,体验炸裂。 假设你提交了五个相互依赖的补丁,审查者要求改底层第一个。在 Git 里这是一场交互式 rebase 的噩梦。在 jj 里:jj edit <底层变更ID>,改代码,保存。没了。jj 的自动 rebase 引擎会把修改瞬间向上传播到所有子提交。有冲突?不阻断,回头再说。
精细化的历史手术。 想把一个大提交拆成两个?jj split,交互式选择。想把一段代码从提交 A 挪到提交 B?jj move -i --from A --to B。想对历史深处的某个提交做拆分?jj split -r <revision>,后代自动 rebase。这些操作在 Git 里要么极其繁琐,要么压根做不到。
同构共存模式。 这是 jj 最聪明的普及策略。同一个目录里并排维护 .jj 和 .git,你随时可以在 jj 和 git 命令之间切换。IDE 的 Git 插件、CI/CD 流水线、GitHub Actions,全部照常跑。你一个人用 jj,团队其他人完全无感。零迁移成本。
AI 时代的版本控制:为什么 jj 恰逢其时
这是我最想展开聊的部分。
今年年初我的文章里说过,未来每个工程师都是管理者,管的不是人,是一群 AI 智能体。想象一下,三五个智能体同时在一个代码库里干活:一个写业务逻辑,一个写测试,一个做重构,一个生成文档。传统 Git 会怎样?
死锁。 Git 的文件锁机制碰上并发写入,要么阻塞要么损坏。
阻断。 两个智能体的修改产生冲突,Git 立即挂起,停下来等待来处理。可智能体不会停下来解决冲突,很多时候会挂起需要人工介入。
所以目前我们最好的妥协是使用笨拙的 git worktree,虽然解决了局部死锁的问题,但合并时产生的冲突,还是需要停下来解决。
jj 的无锁并发模型加上一等公民冲突,刚好治这两个病。
它的操作日志本身就是一个 DAG(有向无环图)。每个操作生成一个不可变的操作对象,关联一个“视图对象”,记录了仓库在那一瞬间的完整状态快照。并发操作不需要加锁,各自独立写入新的操作节点。出现分叉了?下一次命令启动时自动合并,干净利落。
也就是说,多个 AI 代理可以在同一个代码库上无锁并行工作,互不干扰。哪怕改了同一个文件,冲突也只是静默记录下来,不会阻断任何代理的执行流。
更有意思的是,jj 的操作日志天然就是 AI 智能体的“因果记忆库”。每一次操作、每一次冲突、每一次 rebase,都有完整的因果链。智能体可以从中学习:哪些修改序列导致了构建失败,哪些路径走进了死胡同。走不通了?jj undo 瞬间回到安全点,换条路再来。
Git 的设计前提是:参与者是人,遇到冲突能停下来想一想。但 AI 时代需要的是系统本身能兜住并发和冲突,让参与者按自己的节奏干活,不管它是人还是机器。 jj 恰好就是照着这个思路设计的。
谁在用:不是玩具,是生产工具
一个工具好不好,看谁在用比看功能列表靠谱得多。
Google。 jj 正在全面替换 Google 内部的旧版代码协作工具。Google 维护着地球上最大的单体仓库,工程师日常靠 Piper 和 CitC(云端虚拟文件系统)协作。jj 已经成功对接了这套体系,通过重写 WorkingCopy API 与 CitC 通信,本地只暴露一层极薄的组合链路。按路线图,jj 今年 Q1 在 Linux 环境全面 GA,正式替换老旧的 Fig (Mercurial) 前端。
Mozilla Firefox。 Firefox 的 .git 目录有 5.5GB,上万个分支。多名核心工程师已经在日常开发中重度使用 jj。rebase 引擎面对这座代码巨兽没有崩溃,反而因为“冲突不阻断”的设计跑得更快。Mozilla 官方的源码贡献指南已经加了专门的 jj 章节。
Gerrit 生态。 Gerrit 是 Android AOSP 和 Chromium 用的代码审查系统。jj 的变更 ID 跟 Gerrit 的 Change ID 天然契合,不再需要那个折磨新手的 commit-msg 钩子。Gerrit 官方设计文档已经明确要求全面支持 jj 作为原生客户端。
这不是小众极客的玩具。Google 和 Mozilla 都在用的东西,就是一个严肃的工程选项。
实话实说:现在的短板
公平起见,说说 jj 目前的不足。
部分命令性能还在追赶。 比如 jj file annotate 跟 git blame 相比,在超大仓库上查询速度还有差距。好在同构共存模式下,随时可以切回 git blame 补一刀。
生态还在建设期。 GUI 工具、IDE 深度集成都还在早期阶段,目前主力使用方式就是命令行(不过以后需不需要 IDE 还另说,毕竟都 agent 写代码了)。
有学习成本。 虽然 jj 的心智模型比 Git 简单,但从 Git 切过来需要“忘掉”一些肌肉记忆。比如你得接受“没有暂存区”、“不用给分支起名字”这些看似反常识的设定。
这些都是一个年轻项目的正常状态。核心引擎已经过了 Google 和 Mozilla 级别的验证,剩下的就是生态补齐,这只是时间问题。
怎么开始:零风险试用
想试试 jj,最稳的方式是同构共存模式:
# 安装
brew install jj  # macOS
cargo install --locked jj-cli  # 或者用 cargo

# 在现有 Git 仓库中初始化 jj(不影响 .git)
cd your-project
jj git init --colocate

# 查看状态
jj log

# 开始一个新任务
jj new

# 编辑代码,保存即可,不需要 add
# ...

# 写提交信息
jj describe -m "实现了某个功能"

# 推送到远程
jj git push
.git 目录原封不动,团队其他人看到的还是标准的 Git 提交。随时可以切回纯 Git 工作流,没有任何锁定。
我的建议是:找一个不太关键的项目先用一周,感受一下“工作区即提交”和“冲突不阻断”这两个核心理念。一旦肌肉记忆适应了,就很难回去了。
结语:器之利,道之变
二十年前,Git 替代 Subversion,不是因为 Subversion 不能用,而是分布式协作的时代需要一套新的基础假设。
今天,jj 不是要立即替代 Git。它站在 Git 的肩膀上,用完全兼容的方式,为 AI 并行编程、超大规模仓库、无恐惧的历史重写,提供了一套更合理的基础假设。
工具的进化,本质上是工作方式的进化。 当我们从“一个人写代码”走向“一个人指挥一群智能体写代码”,版本控制系统的并发模型、冲突处理策略、容错机制,都得跟着变。jj 恰好在这个拐点上,给出了一个漂亮的回答。
我常常说一件事情值不值得你投入时间去学习,判断标准很简单:它有没有改变你做事的方式。我认为 jj 是未来两三年最值得花时间学的开发工具之一。 它会改变你对版本控制的认知,改变你和 agent 开发的习惯,甚至它的底层技术会影响你对自己项目数据存储的思考。