驯服昂贵的算力:一次机器学习训练平台的搭建手记
工欲善其事,必先利其器。——《论语·卫灵公》
题记:这几天工作里有个看上去不大的项目:在 GCP 上给 ML team 搭一个用于 training 的 GKE cluster。
说它“小”,是因为单纯把 cluster 搭起来并不难。起节点池,装 GPU driver,配网络、身份、镜像仓库,再跑几个 smoke test。对一个做惯了云和 k8s 的后端工程师来说,这些都算熟门熟路。真正让我犹豫的是另一件事:如果我只是把 cluster 搭完,然后丢给 ML infra team,甚至丢给 MLE 自己去折腾,那这件事其实没什么价值。
因为集群不是终点。集群只是一个舞台。
真正麻烦的是戏怎么开场:任务怎么提交,资源怎么排队,状态怎么看,日志怎么查,训练卡住了怎么定位,GPU 等了半天没有分到怎么办,跑了很久才发现配置错了又该怎么办。更现实的是,大家都没什么 GCP 经验,一旦中间横着 Kubernetes、GCS、IAM、NetworkPolicy、GPU quota、JobSet、Kueue 这些东西,就难免来来回回掰扯。你问我一个 Pending 为什么 Pending,我让你贴一段 manifest;你改一行 YAML 再试一次,半小时又过去了。
如此往复,算力还没开始燃烧,人的耐心先被烧干了。
所以我一开始就觉得,这件事不能只停在“搭 cluster”。它必须往前多走一步,走到 MLE 真正能用的位置。所谓“善战者无赫赫之功”,平台工程也是如此。最好的平台不是让人惊叹你用了多少复杂组件,而是让使用者忘了这些组件存在过。
一开始,我只是想让它别太难用
反正这次是在 GCP 上做实验性质的 POC,我就自作主张使用了 Kueue。
为什么是 Kueue?因为训练任务和普通后端服务不一样。后端服务可以先起三个副本,再慢慢扩到十个;分布式训练不行。它要的是 gang scheduling:要么所有 worker 一起拿到资源,要么一个都不要。少一个 rank,全组都开不了工。否则就会出现最糟糕的状态:几个 Pod 已经占住 GPU,但训练跑不起来,只能在那里干等。
GPU 不是 CPU。CPU 空转几小时,最多心疼一下;H100 集群空转几分钟,那就是账单在流血。
于是,Kueue 成了第一道闸门。它不替换 Kubernetes 默认调度器,只是在前面加一层“准入控制”:队列里有没有 quota?这个团队能不能借用别人的额度?这个任务要的 GPU flavor 有没有容量?该不该被更高优先级任务抢占?这些问题先在 Kueue 那里问清楚,再决定要不要放行。
接着,我又设计了一个简单的任务提交脚本,让 MLE 可以提交 JobSet。那时它还很粗糙,本质上只是把若干模板、镜像、参数、队列标签拼起来,然后生成 Kubernetes 资源。但它已经有一个重要方向:不要让 MLE 手写一堆 manifest。
为了确保流程不是“看起来能跑”,我写了几个不同规格的 training example:单机单卡、多机多卡;轻量的 smoke test,稍微像样一点的 fine-tuning;能跑在 L4 上的,也能跑在 H100 上的。最后我在 L4 上跑通了一个 Qwen 0.5B 的 fine-tuning,当作真正的 smoke test。
这一步很关键。平台工程最怕“架子很好看,第一口气喘不上来”。只有一个从镜像构建、任务提交、资源准入、Pod 启动、数据加载、训练开始、日志输出、checkpoint 写入都走完的例子,才算这条路真的通了。
第一次交给 MLE,问题才真正开始
做好之后,我直接交给 MLE 试用。他把一个训练任务跑在 8×H100 cluster 上,也顺利通过了。
这当然让人松一口气。但平台真正的验收,不是“能跑起来”,而是“别人愿不愿意继续用”。很快,他就提了一些使用上的不便。
第一,infra 还是太难用。哪怕已经有了脚本,底层仍然泄露了太多 Kubernetes 词汇。要改 manifest,要理解资源声明,要知道某个字段为什么这么写。这些东西对平台工程师来说是常识,对 MLE 来说却是噪声。
第二,有些本来可以更早发现的问题,要等到训练真正加载数据时才暴露。比如配置里少了一个环境变量,依赖装漏了一个包,data collator 处理变长 label 的方式不对。每次都要等镜像构建、Pod 调度、GPU 到位、脚本启动,最后在第一个 batch 崩掉。错当然是小错,但它发生得太晚,于是浪费了宝贵的工程师精力和昂贵的 GPU 时间。
第三,observability 不够好。任务到底是在排队,还是在拉镜像?是 initContainer 卡住了,还是 GCS mount 出问题?是 quota 不够,还是没有 H100 容量?日志在哪?状态怎么看?如果答案是“你 kubectl describe 一下”,那平台就还没有把自己的活干完。
这几个反馈听起来朴素,却正中要害。
很多平台不是输在不能跑,而是输在每一次失败都需要用户去理解平台内部实现。一次两次还行,多几次之后,大家就会本能地绕开它。
于是,我把 Kubernetes 收进了一个 CLI 里
那天下午之后,我做了一个决定:把所有 GCP 和 Kubernetes 相关的东西都抽象到一个 CLI 里。
这个 CLI 的目标很简单:让 MLE 的世界里只剩一个概念——run。
没有 Pod,没有 JobSet,没有 ResourceFlavor,没有 ClusterQueue,没有 Workload,没有 namespace。那些东西当然都存在,但它们应该活在平台内部,而不是出现在用户心智里。庄子说“得鱼而忘筌”,平台就是那个筌。鱼拿到了,用户不该天天背着筌走。
于是命令长成了这样:
init      从模板生成一个 training run,离线完成,不碰集群
submit    构建镜像 → 推送镜像 → 校验配置 → 渲染资源 → 创建 JobSet
status    用人话解释状态,不把 Kubernetes 原词甩给用户
logs      只看训练容器日志,不混 sidecar 和 initContainer
resume    从最新 checkpoint 续跑
cancel    优雅排空后下线
cleanup   按标签清理残留资源
ls        列出最近的 run、阶段和成本
init 子命令会从模板生成 training 相关文件。MLE 只需要改那些真正跟实验有关的东西:模型、数据路径、batch size、学习率、训练步数、GPU 数量。至于 service account、node selector、安全上下文、Kueue queue、GCS mount、drain 时间、镜像仓库,这些都不应该每次让人重新想一遍。
submit 则做得更重一点。它会自动 build Docker image,push 到 Artifact Registry,拿到 image digest,再用 digest 渲染 JobSet。这里我刻意避免 :latest,因为训练任务不能跑在一个会漂移的标签上。今天能复现,明天才有资格调参。
提交前,它还会做一堆检查:配置里的 ${...} 有没有没填的;训练数据路径能不能访问;对象存储权限是不是通;必要的 secret 有没有挂;镜像架构是不是对;一些明显会被 Pod Security 拒掉的字段有没有问题。能在本地或 init 阶段发现的错误,就不要等到 H100 到位之后再发现。
status 是我花心思最多的地方。
因为 status 看似只是一个命令,其实是平台体验的命门。它不能把底层状态原样甩给用户,而要翻译成可理解、可行动的信息:
Run:              qwen-finetune-0529
阶段:              正在排队
原因:              需要 8 × H100,当前队列暂无完整容量
队列:              ml-training / h100-flex
最近事件:          12 分钟前进入 Kueue,尚未 admitted
镜像:              已构建并推送,digest 已固定
配置检查:          通过
最近 checkpoint:  无
建议:              可切换到其他 region,或降低 GPU 数量后 smoke test
如果已经开始训练,则应该像这样:
Run:              qwen-finetune-0529
阶段:              正在训练
进度:              step 1450 / 100000 (1.5%)
最近 loss:         2.834(3 分钟前)
最近 checkpoint:  step 1000,12 分钟前
自动重启:          已开启(还剩 3 次)
GPU:              8 × H100
健康:              正常
这中间有一堵很重要的墙,我称它为“Kubernetes 词汇防火墙”。
SchedulingGated 要翻译成人话。ImagePullBackOff 要告诉用户是权限问题、tag 不存在,还是镜像架构不对。Init:Error 要指出到底是 GCS mount 失败、身份令牌取不到,还是 DNS 不通。Workload Suspended 不能只说 suspended,而要解释它还在队列里等 Kueue 准入。
我心里有一个硬指标:status 的输出应该足以诊断 90% 的故障,不需要 MLE 去 kubectl describe。剩下 10% 真要下到底层,也应该由工具明确告诉他该看什么,而不是让他在集群里盲人摸象。
为了让 status 足够快、足够稳,我后来还写了一个 k8s operator。它把训练过程中的各种状态物化出来:Kueue 是否 admitted,JobSet 是否创建,Pod 是否齐,init 是否完成,训练是否开始,最近 step 是多少,最近 checkpoint 在哪里,是否进入 draining,是否可恢复。这样 CLI 不需要每次都临时扫一堆 Pod、Event、PVC、GCS 对象,而是读一个干净的 TrainingRun 状态。
这是一个很典型的平台工程取舍:底层可以复杂,但上层必须简单。
回头看,训练任务到底麻烦在哪里
我并不是 ML training 专家。作为一个后端工程师,我最初看训练任务,脑子里其实很容易套用传统模型:打镜像,扔进调度器,起几个 Pod,跑完退出,日志进系统,失败了重启。
后来才慢慢意识到,训练任务有几个脾气,跟普通后端任务完全不同。
第一,训练跑得久,而且贵。 一个像样的训练任务,短则几小时,长则几天、几周。它吃的不是普通 CPU,而是 GPU。几十张 H100 连开一周,那真是真金白银哗哗往外流。所以在这里,“任务白跑了”不是浪费几分钟 CI 时间,而是堪比发哥用美金点烟。
第二,训练不是一个进程,而是一群进程要一起活。 单机单卡训练还好,一个进程吃满一张卡。模型一大,单卡放不下,就得拆到多卡、多机。每一步训练,各个进程都要互相通信、同步梯度。粗暴一点理解,就是大家每一步都要“对答案”。这意味着一件事:这群进程必须同时就位,少一个都开不了工。后端服务起十个副本,起来三个也能先扛流量;分布式训练不是这样,它讲的是“同生共死”。
第三,训练的状态都很贵,没存下来就等于没跑。 训练的本质是读数据、计算、把模型参数往正确方向挪一点。这个中间成果叫 checkpoint。后端服务挂了重启,最多丢几个请求;训练任务挂了,如果没有 checkpoint,几个小时的计算就像没发生过。你不是丢了一个 Pod,你是丢了一段昂贵的时间。
第四,写训练代码的人,不该被 Kubernetes 折磨。 MLE 的心智模型很朴素:一次训练 = 我的代码 + 一批 GPU + 一个启动脚本。他不想知道 namespace 是什么,不想理解 ResourceFlavor,不想排查 SchedulingGated,更不想对着 kubectl describe pod 猜为什么卡在 Pending。每多让他碰一次这些东西,就是在把本该花在模型上的注意力,转移到基础设施的泥潭里。
把这四点记住,后面的设计就都顺了。
训练平台要解决的根本问题,不是“怎么把 PyTorch 跑在 k8s 上”,而是:怎么让一群昂贵的、必须同生共死的、状态易失的进程,在算法同事几乎感受不到底层复杂度的前提下,稳定、便宜、可恢复地跑完。
那些真正值钱的坑,都藏在接缝里
这个项目做下来,最有意思的地方不是 GKE,也不是 Kueue,而是那些接缝。
平台工程里最贵的事故,往往不是大架构错了,而是一个小默认值、一个小权限、一个小占位符,把一堆昂贵的 GPU 拖下了水。千里之堤,溃于蚁穴;很多训练事故就是这样开始的。
配置少了一个变量,机器先烧起来了
训练脚本的配置文件里常有一堆占位符,比如 ${SOME_ENV},指望运行时被环境变量填上。
结果有一次漏了一个 tracking_uri。任务起来了,模型也拉了,数据也读了,到训练第一步才崩。每次从 Pod 启动到崩溃,都要白白烧掉 GPU 时间。连崩几次,才把变量补齐。
这件事给出的教训很简单:花 GPU 钱之前,先用一个几乎不要钱的步骤,把所有配置占位符解析一遍。缺一个,直接拒绝启动。不要等八张卡都占上了,才让一个字符串告诉你“我没填”。
为了保住机器,反而保住了账单
某些便宜的 GPU 容量会被云的自动伸缩随时回收。为了不被回收,有人加了一个“占位 Pod”,死死占住节点。听上去挺聪明:先把机器占住,训练来了再替换。
直到训练任务在写第一个 checkpoint 之前就挂了。训练没了,占位 Pod 还在,八张 H100 还被牢牢占着,上面什么都没跑,只是在等人发现。原本是保命机制,转身成了烧钱机器。
这件事的教训是:任何占住资源的机制,都必须配看门狗。一旦任务已经没有恢复价值,比如挂了且没有任何有效 checkpoint,就要立刻把占位的东西收掉。占资源可以是策略,但不能是信仰。
一个新任务,要穿过五层地雷
最典型的坑,是一个全新的训练 Pod 从提交到真正开始算,要连续穿过五层门:
1. 准入层   — 调度器配额、资源类型匹配、Pod 安全策略
2. 身份层   — 工作负载身份联邦,让 Pod 能以云身份访问资源
3. 存储 I/O — 对象存储挂载 sidecar、桶级权限、元数据服务可达
4. 网络层   — DNS 解析、私有 API 访问、必要公网出口
5. 应用层   — 镜像依赖、训练代码、数据拼接逻辑
最麻烦的是,报错出现的层,往往不是问题真正所在的层。一个 PodInitializing 卡住,十有八九不是 kubelet 抽风,而是存储挂载在等一个 60 秒超时,或者 DNS 根本解析不出来。
我当时排出来的坑包括:Pod 安全策略是 restricted,裸 manifest 没设 runAsNonRoot,没 drop capabilities,直接被拒;给 Pod 身份绑权限时加了“只能访问某前缀”的 IAM 条件,结果对象存储挂载启动时做的是桶级检查,条件不匹配,表现成神秘超时;网络默认全拒,忘了放行元数据服务,身份令牌取不到;节点本地 DNS 缓存绑在链路本地 IP 上,但网络策略只放行了 kube-system 的 Pod,DNS 静默失败;Dockerfile 里有些间接依赖没安装全,跑起来才走到特定位置才崩溃;镜像仓库开启 tag 不可变,构建脚本还在推 :latest,第二次构建直接失败;最后,所有基础设施都绿了,训练在第一个 batch 崩了,因为监督微调用错了 data collator,变长 label 拼不成张量。
你看,前面一长串跟机器学习几乎没有关系,全是基础设施的脏活。但每一个都能让 MLE 卡上半天。一个好训练平台的价值,八成都在这里:把这些地雷一次性封死,让算法同事只需要面对真正属于他的算法问题。
平台先分层,选型才不乱
如果一上来就问“用 Kueue 还是 Volcano,用 Ray 还是 Slurm”,很容易陷入工具崇拜。
训练平台看起来工具满天飞:Kueue、Volcano、Ray、Slurm、JobSet、Kubeflow、SkyPilot,每一个都说自己能解决问题。真要做判断,先把层次分清楚。
我现在更愿意把训练平台从下到上拆成五层:
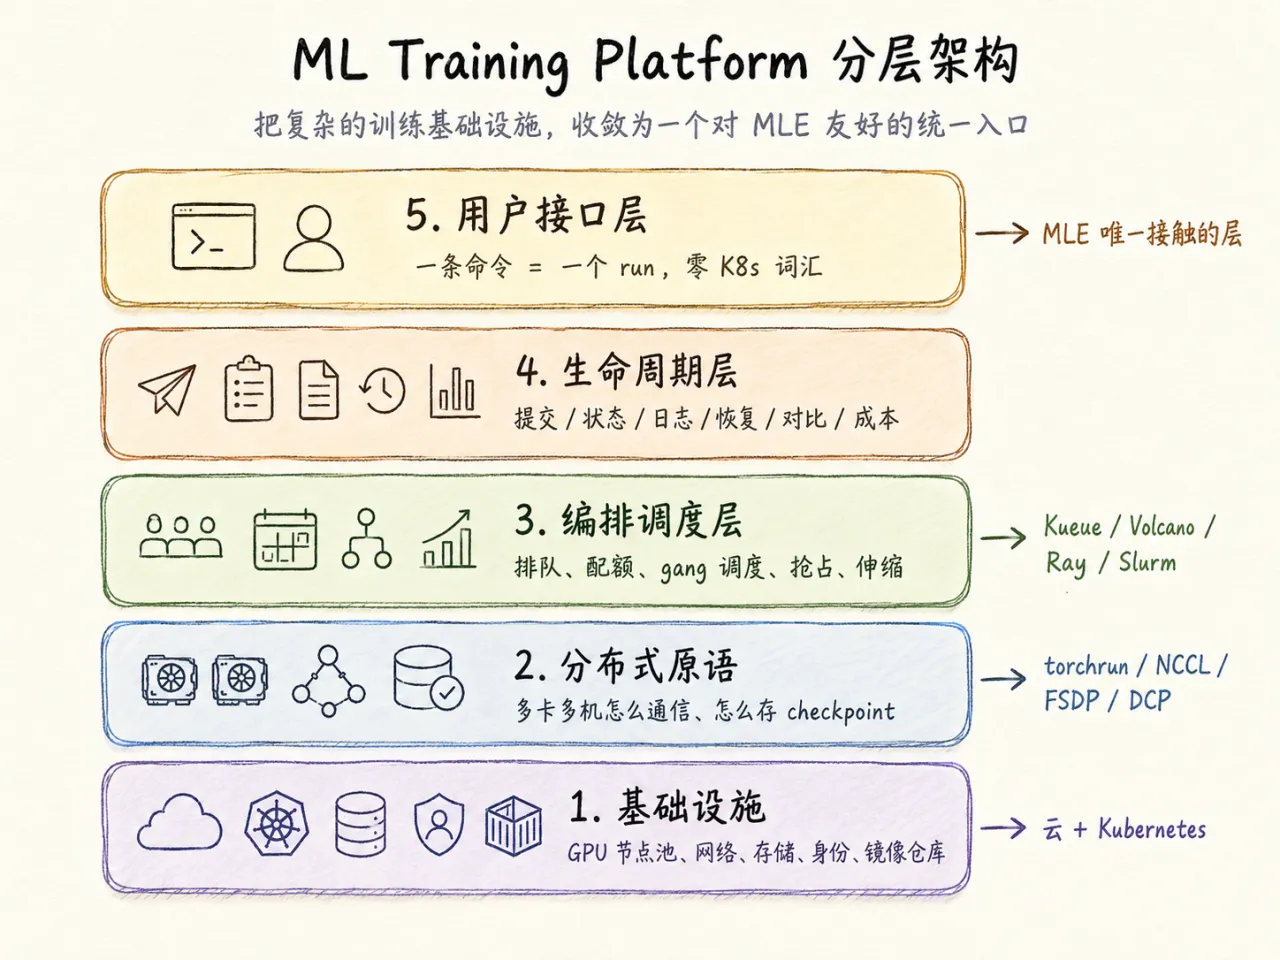
这里面有一个关键判断:第 1、2 层不要自己造;第 3 层认真选;第 4、5 层才是平台真正的差异化。
很多团队把精力全砸在底层,因为那部分看起来最“硬核”。结果调度器装得漂漂亮亮,用户还在天天写 YAML、查 Pending、猜 ImagePullBackOff。那就本末倒置了。
好的平台,不是让人看到你用了多少高深组件,而是让使用者感受不到这些组件的接缝。
分布式训练原语:看懂就好,别急着造轮子
PyTorch 生态已经把很多底层问题解决得很好。平台工程师不一定要会写 FSDP,也不一定要手搓分布式 checkpoint,但必须理解这些组件的行为。因为上层可靠性设计,全部建立在对它们脾气的理解上。
多卡训练通常用 torchrun 这样的启动器。它负责在每台机器上拉起 N 个 worker,并给每个 worker 注入 RANK、WORLD_SIZE、MASTER_ADDR 等关键环境变量。训练代码读取这些变量,才知道“我是谁”“一共有多少人”“头节点在哪里”。这些值绝不能写死。
有一个行为尤其重要:任何一个 worker 挂了,torchrun 往往会把整组 worker 都杀掉重启,而不是只救那一个。在弹性模式下,如果节点数量变化,重启后的 RANK 和 WORLD_SIZE 也会变化。
这直接推出两条铁律:训练代码启动时,就应该尝试加载最新 checkpoint;checkpoint 要存得足够勤。因为一次失败,整组进程都会从上一个 checkpoint 重新来过。
多卡训练里的梯度同步靠 NCCL。你不用亲自写 AllReduce,但要知道一件事:多机训练的性能,极度依赖网络拓扑。同一台机器里的卡走 NVLink 很快,跨机器就要看高速网络、RDMA、网卡选择和 NCCL 配置。跨机网络没配对,训练可能不会报错,只是慢到不可接受。这类“没坏,但很慢”的故障,最折磨人。
模型一大,单卡显存放不下,就要用 FSDP 或 DeepSpeed ZeRO,把参数、梯度、优化器状态切片分散到多张卡上。平台层通常不替 MLE 做这个选择,这是训练代码的一部分。平台要理解的是:一个任务要求 8 张卡,很多时候不是为了更快,而是单卡真的放不下。这也解释了为什么训练任务必须 gang 调度,不能先起几个算几个。
可靠性体系的地基,是 checkpoint。
最朴素的做法,是 rank 0 把整个模型 torch.save 成一个大文件。问题也很明显:慢,容易成为瓶颈,而且换了并行度可能读不回来。PyTorch 的 torch.distributed.checkpoint 会让每个 rank 并行存自己的分片,并且在加载时重新切分。比如用 64 卡存下来的 checkpoint,可以用 8 卡再读回来。
这里有一个关键细节:DCP 会把全局 .metadata 文件放在最后写。只有所有分片都写完,协调者才写这个元数据文件,表示“这个 checkpoint 完整”。
这一条是后面判断“什么叫有效 checkpoint”的根。一个 checkpoint 目录里如果没有最后写出的标记文件,它就是半成品,绝不能拿来恢复。把半成品当存档,会让你陷入“崩溃 → 从坏档恢复 → 再崩溃”的死循环。
调度层:我为什么从 JobSet + Kueue 起步
普通 Kubernetes 默认调度器,是一个 Pod 一个 Pod 地塞。对无状态服务没问题,对分布式训练却很危险。
训练任务需要的是 gang 调度,也就是“全有或全无”。假设一个任务要 4 个 worker,默认调度器可能先塞进去 3 个,第四个因为资源不够卡住。那 3 个已经拿到 GPU 的 worker 就只能干等,既跑不起来,又占着卡不放。这不是排队,这是死锁。
GPU 调度还有两个问题:公平和抢占。GPU 贵又少,多个团队共用一个池子,不能谁先提交谁占满,也不能低优先级任务永远霸着卡。调度器必须知道配额、借用、优先级,以及在必要时把资源还给更重要的任务。
主流方案大致可以这样理解:
| 方案 | 心智模型 | 对用户的侵入性 | 适合谁 |
|---|---|---|---|
| Kueue | 在原生调度器之上加一层“配额闸门”,只决定任务何时准入,放行后交还给原生调度器摆 Pod | 低。任务还是标准 Job,只多一个队列标签 | 想保留 Kubernetes 原生调度,只补配额、公平、借用的团队 |
| Volcano | 替换默认调度器,自己接管 Pod 摆放,gang、公平、拓扑都在它里面 | 中。Pod 要显式指定 schedulerName: volcano |
重度批处理、HPC on K8s,需要强 gang 和拓扑感知 |
| Ray | 用一套 Python API 把数据预处理、训练、调参、推理串起来,K8s 上跑 RayCluster / RayJob | 中高。代码要按 Ray 的模型写 | 工作负载不只是“一组一样的 Pod”,需要动态任务和运行时伸缩 |
| Slurm | 经典 HPC 作业系统,sbatch 提交,squeue 看队列 |
用户用 Slurm,不直接面对 K8s | 有 HPC 传统、研究员已经熟 Slurm、MPI 负载很重的团队 |
| Kubeflow Trainer | 用户给 Python 函数,管理员提供 runtime,底层用 JobSet | 低。用户不碰 Pod 模板 | 想给 MLE 一个 Python SDK,把分布式细节藏起来的团队 |
我更偏向从 JobSet + Kueue 起步。
Kueue 的哲学很干净:它不替代 Kubernetes 默认调度器,而是在前面加一道准入闸门。它把容量抽象成几层对象:
- ResourceFlavor:描述一种 GPU 节点池,比如 H100 按需池、H100 弹性池、便宜的 spot 池。
- ClusterQueue:通常按团队建,定义这个团队在各种 flavor 上的配额。
- LocalQueue:团队 namespace 里的队列,指向上面的 ClusterQueue。
MLE 需要做的事,最好只剩下一件:告诉平台这个 run 要用哪个 queue。至于底层是不是给 JobSet 打了 kueue.x-k8s.io/queue-name 标签,用户不必知道。
这就是好平台应该追求的范式:复杂度存在,但它不应该出现在用户的视线里。
如果场景不只是一次训练,而是“拉数据 → 预处理 → 训练 → 评估 → 注册模型”的流水线,就需要再往上一层看工作流编排器。Airflow、Dagster、Metaflow、Flyte、ZenML 都在解决 DAG、依赖、重试、缓存、产物血缘的问题。它们跟 Kueue / JobSet 不是二选一,而是上下层关系:工作流编排器管流水线,真正那个重 GPU 的训练节点,还是委托给 Ray、Kubeflow Trainer 或 torchrun-on-K8s 去跑。
平台的核心价值:把脏活封起来
底座搭好,调度器装好,如果到此为止,MLE 面对的仍然是一堆 kubectl、helm、YAML 和 Pending,那平台只完成了一半,甚至还不到一半。
训练平台真正的价值,是把脏活封起来。
Pod 安全策略:模板里默认带好 runAsNonRoot、drop ALL capabilities、seccompProfile。Dockerfile 模板默认创建非 root 用户。不要让每个训练任务重新学习 Kubernetes 安全上下文。
身份:用工作负载身份联邦,把 Kubernetes ServiceAccount 绑定到云身份,避免长期密钥。对象存储授权不要轻易加路径前缀 IAM 条件,因为挂载时常常需要桶级检查,条件不匹配就会变成神秘超时。隔离可以靠不同桶、不同前缀、应用侧约束来做,别让身份层变成玄学。
网络:默认全拒没问题,但必须精确放行三件事:元数据服务、DNS、私有云 API VIP 段。需要拉公网模型权重时,再明确放行 443 出口。节点本地 DNS 缓存绑在链路本地 IP 上这种细节,也要提前处理。
存储挂载:对象存储 FUSE 的缓存参数要平台统一调好,比如并行下载、文件缓存放本地 SSD、只读挂载时使用更积极的元数据 TTL。不要让用户自己搜一堆 mount option。
镜像:默认走云端构建,避免本地 Apple Silicon 构出 arm64 镜像,放到 amd64 节点上直接 exec format error。镜像 tag 要不可变,提交时钉死 digest,永远不要让训练跑在 :latest 上。
这些东西,MLE 一个都不该知道。他感知到的只有一句话:我的任务跑起来了。
内循环:别让改一行代码等十分钟
基础设施封好了,MLE 还有一个巨大的痛点:内循环。
最常见的调试动作,是改一行代码,看它能不能跑。若路径是“改代码 → 云端构建镜像 → 提交 → 等调度 → 等 Pod → 看日志”,那么一个 data collator 配错、一个 import 漏掉、一个 shape 不匹配,都要付出十几分钟等待和一点 GPU 钱。这种日常挫败,会迅速消磨平台的好感。
所以我越来越觉得,平台必须把“昂贵训练”和“便宜验证”分开。
第一,交互式开发 Pod。起一个长期开发 Pod,默认放在便宜的 L4 池,把本地代码 rsync 进去,给用户一个 shell。之后改代码,只同步代码、重新运行,不重新构建镜像。配上闲置自动停机,这是交互式 GPU 最大的省钱杠杆。
第二,便宜硬件冒烟测试。提交时加一个 --smoke,强制用一张 L4,只跑一步,tiny batch。几毛钱就能抓出配置、依赖、数据拼接这类错误,别等 8 张 H100 到位才发现第一个 batch 都过不了。首次提交某个镜像时,甚至可以把 smoke test 做成默认门禁。
第三,Notebook 入口。对研究员来说,JupyterLab 是自然界面。开发 Pod 起好后,顺手拉起 JupyterLab、做端口转发、打印 localhost URL。平台不一定要爱 Notebook,但要承认很多探索工作就是从 Notebook 开始的。
这层做好,MLE 的体验会有数量级提升。安全和成本靠两条线兜住:开发 Pod 默认进便宜池,所有交互式资源都带 TTL;再加一个看门狗,回收孤儿资源。别让“方便调试”变成“忘关的 H100”。
实验追踪:不要挡住标准路径
训练不是只看日志。MLE 需要的是实时 loss 曲线、吞吐、评估指标、历史对比。一个日志查询界面不是实验追踪。
这件事未必第一天就要自建。正确姿势是先接通标准路径:
- 用环境变量注入追踪配置,比如
WANDB_*、MLFLOW_TRACKING_URI。 - run-id 从任务名稳定派生,重启后仍写到同一个追踪 run,别每次重启分裂成一个新实验。
- HuggingFace Trainer、PyTorch Lightning 等框架本来就支持
report_to,让训练框架自己记。 - API key 从密钥管理服务注入,绝不烤进镜像。
平台一开始不必托管 W&B 或 MLflow,但不能挡着它们。只要环境变量和 run-id 约定打通,MLE 立刻能拿到曲线。后续要不要自建追踪,是下一阶段的问题,不是平台落地的前置条件。
围绕 run,还应该自然长出几个动词:
resume <run>:从同一个 run 最新 checkpoint 续跑。fork <src> <dst> --from <checkpoint>:从某个 checkpoint 分叉一个新实验。compare <A> <B>:比较 loss、吞吐、关键指标。cost <run>:把云账单按标签 join 回来,算出这个 run 花了多少 GPU 小时、多少钱。
这些动词听起来像锦上添花,其实是研究工作流的核心。实验不是一次性任务,而是一条不断分叉、回滚、对比的河。
GPU 经济学:省钱不是优化项,是生存项
训练平台里,成本不是后置优化,而是第一天就要写进设计。H100 闲置一小时,就是几十美元蒸发。平台不能只问“能不能跑”,还要时时问“这笔钱有没有花在计算上”。
云上的 GPU 容量大致有四档:
| 档位 | 相对价格 | 被抢风险 | 时长限制 | 适合 |
|---|---|---|---|---|
| 按需 On-demand | 基准价 | 无 | 无 | 关键任务,不能被打断 |
| Spot / 抢占式 | 最低,经常只有原价一小部分 | 随时可能被回收 | 无固定上限,但不稳定 | checkpoint 完善、能续跑的训练 |
| 弹性 / 动态调度 Flex | 接近抢占档价格或配额 | 全有或全无分配 | 通常最长 7 天 | 微调、实验、7 天内能跑完的任务 |
| 预留 / 承诺用量 | 长期可省不少 | 无 | 锁定 1-3 年 | 稳态、可预测的长期占用 |
最大的浪费通常不是单价,而是空转。省钱的关键杠杆包括:
专用 GPU 节点池缩到 0。 没任务时一张卡都不开,有任务时从 0 弹起来。开发池、实验池尤其应该这么做。
按阶段选硬件。 开发、调试、冒烟用 L4 / T4。真正分布式训练再上 H100。别拿 H100 验证一个 import 能不能过。
先便宜验证,再昂贵训练。 smoke test 不是仪式,是成本保险。
必要时做 GPU 共享。 时间片和 MIG 对推理、小任务、开发池有价值。大训练一般用不上,但开发环境可以考虑。
每个 run 都打成本标签。 team、owner、run-id、model、capacity-type,一个都别少。云账单导出后按标签聚合,才能知道每个 run、每个团队烧了多少。提交时甚至可以回显估算:8×H100 大约多少钱一小时,7 天上限是多少。先做 showback,让大家看见钱;未来要不要 chargeback,再说。
“凡事预则立,不预则废。”GPU 成本也一样。看不见,就一定会失控。
可靠性:让长任务有路可退
训练平台最怕的,不是任务失败,而是失败得太晚、太静、太不可恢复。
一个跑七天的任务,在第六天半夜挂掉,没有 checkpoint,没有告警,第二天早上只剩下一地账单,这是平台工程师的噩梦。
可靠性要靠几块拼起来。
checkpoint 约定是地基
先定一个全平台通用的 checkpoint 布局。综合 PyTorch DCP、MosaicML Composer、NeMo 等实践,一个稳妥模式是:临时目录 + 原子重命名 + 完成标记 + latest 指针。
<checkpoint-root>/<run-id>/
  checkpoint-<step>/
      <分片文件...>
      .complete
  latest
写入流程是:先写到 checkpoint-<step>.tmp/,所有分片刷完后,把目录变成正式名字,最后写 .complete。然后更新 latest,让它指向最新的完整 checkpoint。
一个写到一半被杀掉的 checkpoint,没有 .complete,恢复逻辑必须跳过它。判断有效性,不能看“文件是不是够大”,也不能看“目录是不是存在”。大小启发式太脆,目录存在更不说明问题。只有完成标记才算数。
最好给 MLE 一个小工具或库,把 save / load / latest 这套约定封起来。不要让每个训练脚本自己发明存档协议。每个人自己写一遍,最后一定会写出十种半成品。
没有 checkpoint,就别开自动重启
自动重启听起来很美,但如果一个 run 还没有任何有效 checkpoint,就开启自动重启,那它每次崩溃都是从头再来。很多这种任务,本质是配置错了、镜像坏了、数据拼接失败。让它自动重启,只是在自动烧钱。
更稳的做法是:任务启动时 maxRestarts=0。等第一个有效 checkpoint 落地后,控制器看到 .complete,再把 maxRestarts 调成 N。也就是说,有锚点之后才允许恢复;没有锚点时,失败就立即失败。
这条原则很反直觉,但非常重要。自动化不是无脑重试,自动化应该知道什么时候停手。
抢占恢复要形成闭环
Spot / 弹性容量能省钱,前提是任务真的能续上。完整闭环是:
- 使用便宜容量。
- 训练启动时尝试从
latest恢复;没有就从头开始。 - 节点被回收时,torchrun / 调度器触发重启或重新提交。
- 新进程起来后读
latest,从上一个完整 checkpoint 继续。 - checkpoint 足够频繁,抢占代价就只是重算一小段。
如果数据集支持流式、确定性打散和中途恢复,连数据读取都能从中途续上。这对大语料和 spot 场景几乎是刚需。
故障不要静默
长任务最怕静默卡死。进程还在,GPU 还占着,日志不动,step 不前进。可能是 NCCL 卡住,可能是数据加载器挂起,可能是某个 rank 慢得拖垮全组。
平台要有进度心跳:训练步数必须在 N 分钟内前进。连续几个周期没前进,就判定卡死,杀掉触发重启。
但探针不能写死。有人日志字段叫 step,有人叫 global_step,有人指标走 JSONL,字段名不同。如果探针固定 grep 一个字段,它会在几小时后把正常任务误杀,而且毫无线索。进度字段要可配置;第一次错过心跳时,要在日志里写清楚诊断。失败可以发生,但不能悄悄掩盖。
NCCL timeout 也是一种“显性报错”。某个 rank 卡超过阈值,整个进程崩掉。这虽然痛,但比静默占卡强。平台要做的是识别这种失败,给出解释,而不是让用户在日志海里猜。
优雅排空要真的有效
弹性容量有硬截止,spot 也可能随时收回。硬截止往往是 SIGKILL,不是温柔的 SIGTERM。你抓不到它,也没机会善后。
正确做法是在硬截止前预留余量,比如提前两小时主动发信号,让训练保存最终 checkpoint 后退出。
这里也有一个陷阱:如果你只是 kill -USR1 1 || true,而训练根本没装信号处理器,那就是一个静默 no-op。到点照样被 SIGKILL。排空机制必须检查训练是否真的响应,比如落一个 ACK 标记,或者在状态里看到“draining checkpoint completed”。没响应就告警,不要假装排空成功。
平台工程里,最危险的不是失败,而是看起来成功的失败。
存储:对象存储不是文件系统
训练平台里,存储误解特别多。先把各类数据放哪说清楚:
| 数据 | 放哪 | 模式 | 原因 |
|---|---|---|---|
| 训练数据集 | 对象存储,经 FUSE 或 SDK 读取 | 只读 | 便宜,可并行下载 |
| checkpoint | 对象存储 | 读写 | 持久,可跨节点、跨区恢复 |
| 冻结模型权重 | 高性能只读盘或对象存储只读挂载 | 只读 | 加载快,多 worker 共享 |
| 临时打散 / spill | 本地 SSD | 每节点 | 高 IOPS,易失但便宜 |
| POSIX 共享 scratch | 并行文件系统,如 Lustre | 读写 | 真 POSIX,支持随机写和锁 |
最重要的认知是:S3 / GCS 不是 POSIX 文件系统。FUSE 挂载只是给你一个“看起来像目录”的界面,底层还是对象存储。
它的真实脾气是:写入通常是整个对象写,不适合频繁 append;没有传统文件锁,rename 语义也未必等同本地文件系统;小文件很伤,延迟高,元数据操作贵;大量随机读写会让 GPU 等数据,钱就这么空转。
所以实践上要记住几条:
指标和日志不要写到 FUSE 挂载上。 它们是追加型数据,应该走网络上报,或者写本地再转发。
训练数据要尽量打包成大分片。 别把几百万个小文件直接扔对象存储,然后让每个 worker 疯狂 stat / open。
模型权重要钉死版本。 从 HuggingFace 或内部对象存储拉权重时,钉死 commit、digest 或版本号。不要用会动的 main。
本地 SSD 是缓存,不是事实来源。 它适合缓存数据分片、spill、临时解压,不适合放唯一存档。
最后,说一句经常被忽略的话:GPU 利用率低,不一定是模型慢,可能是数据喂不上。流式数据集,比如 MosaicML StreamingDataset 这类方案,能提供确定性打散、中途 epoch 恢复、本地分片 LRU 缓存。对 spot 和大语料训练,它们不是锦上添花,而是让恢复闭环成立的一块拼图。
为啥我要花时间自己做这事?
说实话,这件事本来是可以交给别人做的。
甚至从组织分工上看,搭 GKE cluster、配置 Kueue、封装提交工具、写 operator,这些都可以切成任务,交给不同团队做。Infra 负责集群,ML infra 负责训练 runtime,MLE 负责训练代码,平台团队再做 UI。听起来很合理。
但现实里,这类工作最难的不是每个模块本身,而是它一开始没有清晰边界。它的模糊度非常高:哪些问题算 infra,哪些算训练框架,哪些算用户体验,哪些算成本治理?一个状态应该由 Kueue 给,还是 JobSet 给,还是 operator 自己算?一个失败应该停在 CLI,还是暴露 Kubernetes 事件?这些问题,如果一开始就分给几个团队,很容易变成会议、handoff、ticket、优先级和“这个不归我”。
尤其考虑到整个 team 目前还没有构建和维护 GCP IAM / GKE cluster 的经验,我反而觉得自己一个人趟最合适。
只有亲手做,或者在第一线感受各种问题,才能真正体会那些痛点。而这一年多 AI coding 的沧海桑田,也让这种工作的反馈链被大幅压缩。当我一个人自己做的时候,反馈链变成了我和一个 ML 工程师之间的直接对话。他说这个地方不好用,我回去想一下抽象;他说状态看不懂,我让 agent 帮我把 operator 和 CLI 补上;他说这个检查应该提前,我把它塞进 submit 或 initContainer。基本上他提一个需求,我的 agent 两三个小时内就能做出来。当然,瓶颈主要在我:毕竟我有很多事情同步在做,不能实时盯着;收到反馈后,我还要快速判断做不做,怎么做,抽象放在哪一层,哪些东西现在该封,哪些东西暂时不该封。
更重要的是,我完全是 ML training 的门外汉。这里头大部分知识是全新的,我需要反复和 Gemini/ChatGPT 探讨学习。但慢慢地,通过和 AI agent 合作,通过一次次把训练任务跑起来、摔下去、再扶起来,我也开始掌握一些最佳实践,了解了不少优秀的 training framework,也能构建一些工具,减轻 MLE 的心智负担。
这可能是 AI 时代工程师的全新工作方式:不是每个领域都先成为专家再动手,而是在真实问题里,用很短的反馈链,把专家经验、开源实践和自己的工程判断编织到一起筚路蓝缕,以启山林。
五个小时等不到 GPU,我突然理解了 multi-region
今天下午,还有一个很具体的瞬间。
一个跑在 H100 cluster 上的训练,五个多小时过去了,还没有拿到 GPU 资源。状态不是失败,也不是配置错,就是没有完整容量可以让它开工。
那一刻,我非常具体地感受到了 multi-region 的重要性。
以前谈 multi-region,常常是从高可用、灾备、低延迟这些角度说。但在 GPU 训练场景里,multi-region 还有一个更朴素的意义:容量本身就是不确定的。你有 quota,不代表那一刻有机器;你有一个 region,不代表它总能给你完整 gang;你愿意付钱,也不代表容量马上出现。
对于在线服务,multi-region 是为了用户请求不要断。对于训练平台,multi-region 很多时候是为了让实验不要被一个区域的 GPU 供应卡死。
这也反过来影响平台抽象。run 不应该天然绑定某个 cluster。它应该可以描述“我需要 8×H100,我接受这些 region,我接受这些 capacity type,我最多等多久”。至于最后落在哪个 cluster、哪个 node pool、哪个 queue,那是平台调度层该决定的事。
如果未来继续往前走,这会变成一个更高层的调度问题:跨 region 的 capacity discovery、queue fallback、数据和 checkpoint 的跨区可达性、镜像复制、成本差异、抢占风险、甚至不同 region 的网络拓扑和 NCCL 性能。
换句话说,multi-region 不是一开始就要大干快上,但它一定要从抽象上留口子。否则等你真需要它时,所有东西都已经长死在一个 cluster 里了。
收尾:平台工程的价值在接缝处
如果把这几天的经历压成几句话,我会这样说:机器学习训练平台,本质上是一台吸收复杂度的机器。
它把 k8s 的复杂度吸收掉,把 GPU 的闲置浪费吸收掉,把长任务的脆弱性吸收掉,把云上那些看不见摸不着的配额、身份、网络、存储、镜像、日志、状态,收束成一个 MLE 能理解的 run。
对 MLE,它要让“我的代码 + 一批 GPU + 一个脚本”这个朴素心智模型成真。k8s 的一切,都应该被挡在视线之外。
对账单,它要让昂贵的卡尽量不空转,让便宜容量可用而不危险,让每一笔 GPU 小时都能追到某个 run、某个人、某个团队。
对可靠性,它要让 checkpoint 成为可信锚点,让自动恢复在有锚点之后才启动,让所有失败都大声、可解释、可追溯。
真正稀缺的,不是底层用了多酷的调度器。torchrun、NCCL、FSDP、DCP、Kueue、JobSet、Ray、SkyPilot,社区已经造了很多好轮子。平台工程师的价值,是把这些轮子编织成一辆车,把悬挂调教得体,让坐车的人感受不到路上的颠簸。
《道德经》里说:“天下难事,必作于易;天下大事,必作于细。”训练平台也是如此。宏大的 GPU 集群,最后常常败在一个没填的环境变量、一个没落盘的 checkpoint、一个静默 no-op 的排空信号上。
这也是为什么我愿意亲手做这件“小事”。因为只有走进那些细处,才知道真正的问题在哪里;只有把自己也放进使用者的等待、困惑和焦躁里,才知道平台应该替他们挡掉什么。
集群搭起来,只是第一步。
把昂贵的算力驯服,让它少一点空转,少一点玄学,少一点“你去 describe 一下”,多一点确定性、多一点可恢复、多一点人在机器之上的从容,才是这件事真正的价值。