思考,问题和方法
转眼已是七月。距我上次更新公众号,已经一月有余。离我加入 Arcblock,也有两月。如果把人看做一个运行的软件,那么这两个月我已经迭代好几轮,就像龙珠里在飞往那美克星的太空船里不懈修炼的悟空。
人的成长是有诱因的,但不外乎得到他人指点,和自己开悟两种情况。吕蒙原本一介武夫,经孙权劝学后,发愤图强。有次鲁肃跟他议事,大惊失色,于是有了「士别三日,当刮目相待」的故事 —— 这是他人指点迷津。我是因为换了新的环境,破而后立,往日的积累和思考有了实施的空间和对象,又加上自己在西雅图孑然一身,事情又多,于是就把时间都扑在工作上,想得多,做得更多,能力也就上来了 —— 这是自己开悟。
孔子说三十而立,立的是什么?是立德、立功、立言这三不朽么?还是小家子些的,立身,立家,立业?每个在奔四路上的人都会有自己的体味和解读。但不容置疑的是,三十岁往上,要渐渐形成自己的思想和方法论。上篇文章 Code is Law,我为 Arcblock 的 github repo 定义的一套规范,就是我自己的思想和方法论的产物 —— 你在任何已有的公开的文档中找不到类似的做法。它完美么?不,肯定不,我们在使用一段时间后已经有了一些新的感悟;它独特么?独一无二,且很有价值。
我在 上帝说:要有一门面向未来的语言,于是有了 erlang 引用了 Joe 老爷子在其博士论文中提到的他对 erlang 的 worldview:
- everything is a process.
- process are strongly isolated.
- process creation and destruction is a lightweight operation.
- message passing is the only way for processes to interact.
- processes have unique names.
- if you know the name of a process you can send it a message.
- processes share no resources.
- error handling is non-local.
- processes do what they are supposed to do or fail.
而在 Joe 的眼里,erlang 其实没有什么神秘的,仅仅六个函数就能涵盖它的全部:spawn,send,receive,register,whereis,self。
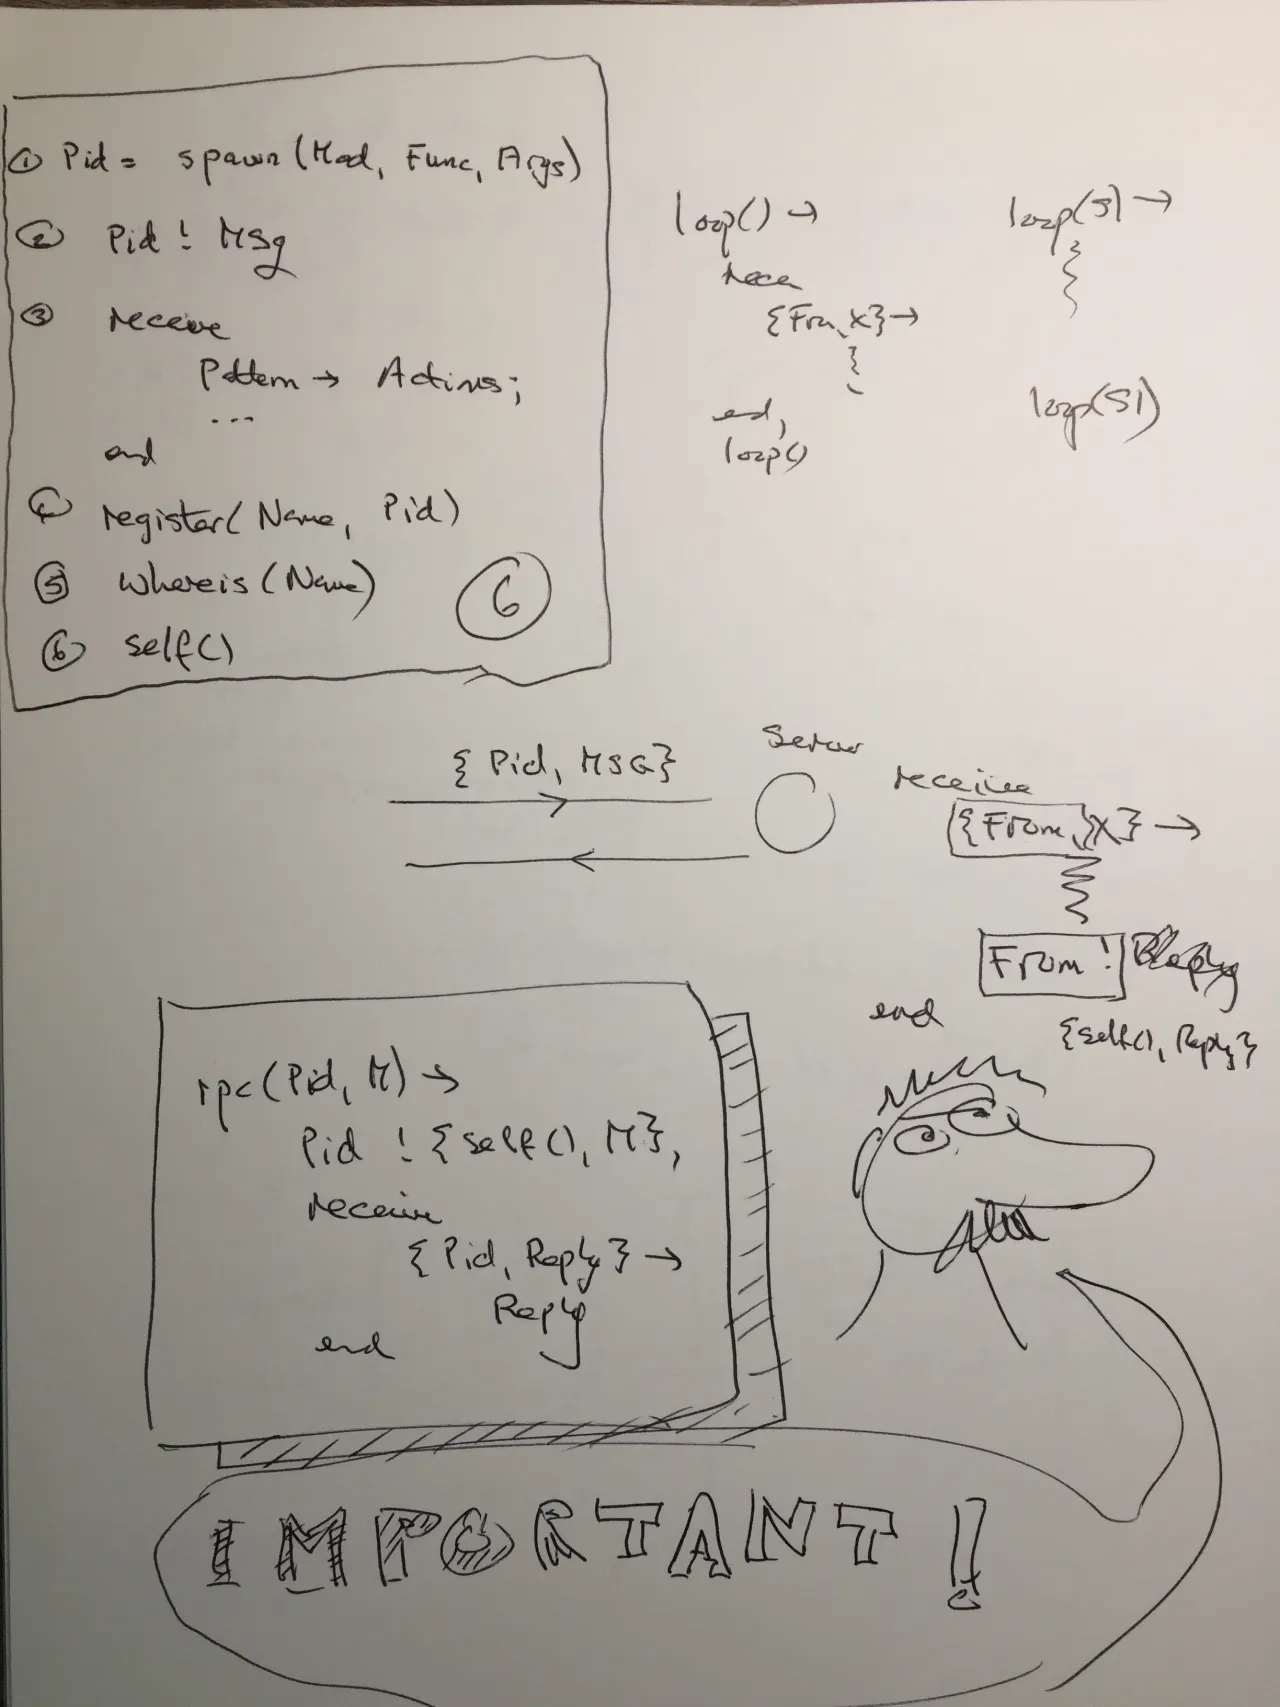
(感谢小山同学贡献的老爷子亲笔阐述)
仔细想想,它简单地可怕,就像物理学的大一统理论一样,试图从纷繁复杂中跳脱出来,回归本源。更可怕的是,这六个函数不仅仅涵盖了 erlang,似乎也可以解释软件领域里的很多系统 —— 它们无所不在,在系统里面的意义就像原力之于星战。
- spawn:创建一个资源。对于 erlang,这资源是 process;对某个 service,是 service 本身。
- send / receive:给资源发指令和接受指令。对于 erlang,这指令是 message,封装成 erlang term,走的是 IPC/RPC;而对某个 http service,指令是 request,封装成 json / msgpack / protobuf,走的是 http / http2。
- register / whereis:资源怎么注册,怎么发现。对于 erlang,这是 process 在 name register 的注册和发现;对于某个 service,可以是 Consul / DNS。
- self:返回自己的 identity。在 erlang 里,这是 process 找寻自我的方式;在 micro service 的场景下,每个 service 隐含着有自己的 identity。
我喜爱 Joe,和我喜欢 Rich Hickey 一样,他们在传播知识的同时,传播他们自己对事物独特的理解和思考。
回到我自己对做事的流程和方法的感悟。那些表层的方法之下,其实蕴含着一个重要的思考:如何让团队低成本的沟通和协作。我的方式是:convention by configuration。你弄懂了一个 repo 的结构,知道 make init,make build,make run,make create-pr 干些什么之后,就自然懂得我们在 arcblock 里所有 repo 的运行法则 —— 不管它是 elixir,还是 nodejs,还是 python。也不管 elixir 是否使用 asdf,nodejs 是否使用 nvm,python 是否使用 virtualenv,一个 make init 就把所有的环境帮里构建好,然后就可以安全地 make build 以及 make run 了。一个新来的工程师不需要跑来问我(或者其他人),这个 repo 怎么初始化,怎么运行起来,这大大节省了我们的时间;同时他也不需要为了能运行起来费力去读 READMME.md 里一个长长的「安装须知」的章节,因而也大大节省了他的时间。
这只是冰山的一角。我们还做了很多其它降低团队沟通协作成本的工作。而为大家节省下来的时间和精力,可以被用来做那些更重要的事情。这样点点滴滴的累积,最终有机会转化成一倍或者多倍的生产力,从而形成竞争优势。
我们的 Open Chain Access Protocal(OCAP)选用 GraphQL 而非 REST 接口来做 API 层,也有类似的考量。对于开发者而言,起初,他们有一些学习曲线,适应之后,我们无论是提供 1 个 API 还是 100 个 API,是支持一条链还是若干条链,对使用者的使用成本都是近似的。而 REST API,学习 100 个形态各异的 endpoints 对开发者来说将会是个梦魇;对于我们自己而言,初期搭设地基需要很多时间,随后,花样繁多的 query 背后,都是几种基本的 resolver 的组合。
「如何让团队低成本地沟通和协作」是我过去两个月的重要思考,也是我过去若干年知识和经验的储备的一次厚积薄发。
这两个月我的另一个尚处在摸索中的思考是:「如何用更先进更高效的方式来构建我们的服务及其生态?」
arcblock 目前是个小团队,即便研发团队发展到数十人的规模,依然很小。在我们想要做的事情的范畴上来看,如果找不到一个更行之有效的开发方式,我们会开发得很累,且开发进度会比较缓慢。就拿 OCAP 来说,打造一套供开发者使用的 API,不仅仅是 API 及其背后的服务那么简单。API 要有文档,要有 SDK,要有 API interface 的定义,以及支撑这个 interface 的服务。这里面会有很多重复的劳动:API doc 和 API interface,以及 SDK 都在不断地重复类似的内容和代码。当我们对 API 的定义进行改变的时候,往往牵一发而动全身,数个地方都需要修改,而这些都是非常机械的行为。所以,我们要寻找能够「降维打击」的方式。
在 Tubi,我做的 UAPI 系统,就整合了 API 和 API 的文档,使其可以一次定义,两处生效,节省大家的时间。而对于 OCAP,我们更进一步,试图把问题定义成这样:
- 定义一门「语言」,来描述我们的 API
- 撰写不同方向上的 Parser(Code generator),将其转换成特定场景的代码
- 将 Parser 构建在 build pipeline 中,可以一次 build,生成各种结果
- 生成的结果要能很方便地扩展,以及和系统里的其他部分整合
我们定义的语言,姑且称之为:AADL(Arcblock API Description Language),为了方便每一个人撰写和理解(比如,产品经理也可以很方便地定义),我们使用了 yaml 格式,比如 RichestAccounts 这个查询,其定义为:
- name: RichestAccounts
  doc: Returns richest accounts, order by balance.
  return: PagedAccounts
  params:
    - name: paging
      type: PagingInput
      doc: Describes which page of data to return.
而这里面使用的 data structure,是这么定义的:
- name: PagedAccounts
  doc: Represents paginated Accounts.
  properties:
    - name: page
      type: PageInfo
      doc: The pagination information.
    - name: data
      type: [Account]
      doc: The paged Account data.
通过这种定义,我们生成:
- slate 风格的 API 文档(github.com/lord/slate)
- Absinthe 的 GraphQL 的 query schema 定义(Absinthe 是 elixir 的 GraphQL lib)
- Absinthe 的 GraphQL 的 type notation 定义
- Ecto 的 DB repo 定义
- Ecto 的 DB schema 定义
- Ecto 的 DB migration 的定义
- 各种语言的 SDK(比如 nodejs,python,go,etc. 筹划中,还未开始)
然后在一个 build pipeline 里,生成所有代码。比如生成的 Absinthe 的 query 长这个样子:
(
  @desc "Returns richest accounts, order by balance."
  field(:richest_accounts, :paged_bitcoin_accounts) do
    [
      (
        @desc "Describes which page of data to return."
        arg(:paging, :paging_input)
      )
    ]

    resolve(fn parent, args, resolution ->
      apply(Resolver, :paged_bitcoin_accounts, [parent, args, resolution])
    end)
  end
)
以上生成的代码符合前文中所述的「生成的结果要能很方便地扩展,以及和系统里的其他部分整合」这个限定条件。在这个例子里,程序员只需要进一步撰写 Resolver.paged_bitcoin_accounts 这个函数就可以了。
目前这套流程还在实验当中,我们线上的服务,OCAP playground 就跑的是生成的代码。我们自己写了大约 3500 行 elixir,1000 行 yaml;生成出来 1500 行 elixir 代码(Elixir 支持 Macro,所以我们生成出来这些源码只是方便自己排查问题)。
虽然还有很多问题,但这套系统最大的好处是,在开发过程中,我们可以随意调整 API 的结构而不必每次调整都苦逼修改很多地方的代码。这在我们对很多 API 的行为还没有一个良好定义的时候,是个莫大的福音。而之后,当我们要大规模增加新的 API 时,我们将能够很快地支持。
这目前是我们对「如何用更先进更高效的方式来构建服务及其生态?」的一个答案。它离完美还有十万八千里,但立等可用。很多时候,问对问题比找对答案更有意义。好的问题就像在黑暗的隧道里寻觅出口,突然手边摸出一把手电筒,瞬间照亮整个征途。
先写这么多吧,希望能引发你的思考和问题。
用 elixir 构建服务其实是另一个答案。elixir 的好处是你随时可以把某部分的代码拉出来单独组织成一个 GenServer,就像是一个微服务一样。上文中的 Richest Accounts 查询,其实非常适合单拉出来变成一个 GenServer,然后自己定期从数据库里抓数据,缓存下来,这样能大大减轻 DB 的压力。
unfair advantage
mission
很多时候,时间偷偷地溜走,我们却在原地踏步:解十年如一日的
要么,得到前辈指点,像令狐冲和风清扬,张无忌和白猿;要么,自己突然开悟,
上篇文章 Code is Law,阐述我对做事方法和原则的一些心得。其实方法是什么,
一个半月没更新。
我想哪怕是最坚定的读者
亲爱的读者朋友们,我想死你们啦~
前两天一位设计界的前辈,EICO 的创始人 Rokey 来 Arcblock 给我们做了一场精彩的 BBL,醍醐灌顶,让我重新认识了设计。比如他说:
商业的起点是资产,然后变成模式,然后形成品牌,到达用户,最后转换成新的资产。
产品是一个容器,她满足体验,承载业务,支撑理念,传递认知。
最让我触动的是他说:团队低成本协作能力是公司最大的竞争优势,这我简直不能赞同更多
场景和业务 增长
产品是承载用户价值的容器
重新定义工程师
建筑:人和环境,定制化 工业:人与商品,量产,流水线 数字:人和信息,无限复制,0成本+病毒传播,跨行业协作
原理和结构分离,设计和产品可以拆解
竞争对手可能来自于山的另一面,而不一定是在你的行业链上
解决信息过载中有效性的问题
数字产品是什么?起点和过程。但不是关于终点和结果的。终点即死亡。产品没有边界。需要找到动态的稳定性,立足点。pivot。
设计师要有对成就感的定义,一个活着的产品
在新的时间节点上 怎么能帮到他
团队低成本协作是公司最大的竞争优势
一个需求扔进来,挑几个人就是 80 分的产品
用户认知 | 体验 品牌 -+- 资产 理念 | 业务 模式
起点是资产,然后变成模式,然后形成品牌,到达用户,最后转换成新的资产
核心是产品。不是品牌。
The big eye model
产品: 是一个容器
满足体验 承载业务 支撑理念 传递认知
商业要什么?
业务数字化: healthcare
数字业务化:blockchain
商业是个 burger,上层是digital,下层是 physical,中间通过 workflow 串起上下。
设计是把商业,人文和技术串起来的
商业设计 技术设计
设计是一个手段
优剪 - 触点上简单,后面复杂
利益上的冲突,
基石设计:美学管理和可用性管理 内容设计:质量管理:信息运营流程规范 决策设计:方向管理:认知定位原则机制
工具思维 - Thinking in tools
Paul Graham 在《黑客与画家》里谈到:程序员的职业是个完美的职业,因为它兼具 1) 可测量性 和 2) 可放大性。我们常常说一个「优秀」的程序员可以抵得上三五个,甚至数十个「平庸」的程序员。这话也对也不对。「优秀」和「平庸」都是相对的,所谓「汝之蜜糖,彼之砒霜」,Forrest Gump 放对了位置也不可谓不优秀。
确切地说,一个优秀的程序员应该能 carry 一支「平庸」的 team,使其达到原来三五倍,甚至数十倍的效率;或者,一个优秀的程序员应该能合理地寻求解决方案,carry 自己,让自己做某件事情的效率抵得过曾经三五个,甚至数十个自己。
在这里,工具思维起决定性作用。以下是我在十多年的工作过程中,渐渐总结出来的一些工具思维的原则,供你参考。
R1:不在核心路径上的代码,只要性价比合理,能够使用第三方(付费)工具,就绝不自己构建
这个原则并不是否定造轮子的意义。作为工程师,我自己也很喜欢造轮子。在我们的世界里,不断更迭的轮子才是推动软件行业前行的基石。如果没有 php,我们还在使用 CGI;如果不是 rails,复杂的 web app 的开发,只能是一支大团队的禁脔(java/.net);而如果没有 chrome 和 firefox,IE 将是整个人类的梦魇。
其实我们做的每个工作都在造轮子 —— 造一个在你的核心竞争力路径上的更好的轮子。因此在 Tubi,我们的轮子是 transcoding engine,是 ad server,而在 arcblock,我们的轮子是 open chain access protocol,是 blocklet,是 arcblock utility chain。不在核心路径上的轮子,不到必要,不应该轻易去造 —— 这一点对小团队尤其重要,道理很简单 ——「和你们这些少爷不同,我们光是活着就竭尽全力了」。
要能做到这一条原则,首先要厘清什么是核心路径,什么是非核心路径,进而再找到核心路径里面的非核心路径,一路细化下去。这个分析的过程有时是显而易见的,有时是颇伤脑筋的。而且,核心路径是动态变化的,当下不那么重要的东西,可以 trade off 的东西,未来也许就横亘在核心路径上。
比如对 arcblock 来说,开发一门编程语言显然不在核心路径上,开发一个监控系统也必然不在核心路径上。那么,构建一个 scalable / robust / secure infrastructure 呢?打造一个 ETL pipeline 呢?index 现有主链的数据呢?写一个 API gateway 呢?这些都要好好想,哪些可为,那些不可为。
找出来那些不在核心路径上,但又非常重要的服务之后,就是选择使用什么工具。那么,是使用开源方案,还是商业工具,着眼点都落在了一个词:性价比。注意是性价比,而不是价格。很多人会被商业工具的价格吓跑,而丧失了对性价比的判断。尤其当决策者是程序员时,一看价格就忍不住:麻蛋,这玩意我花点时间就能做出来了,竟然要这么贵!脑子进水了吧!
所以做生意不要做程序员的生意,即便不得已做程序员的生意,也要尽量让购买的决策权放在程序员上面的那个不会写代码的老板或者老板娘身上
决定性价比的公式,我是这么考量的:
CPR = (开发成本 + 部署成本 + 维护成本 + 培训成本 + 使用成本)/ 收益
这里面,某个特定工具(如监控系统)的收益几乎可以当成一个常量,所以要降低的是各种 cost。如果你要搭建一个和 datadog 差不多的系统,需要自己搭 grafana / influxdb(算上 terraform / ansible 的部署脚本和搭建的学习时间,至少一个工程师一周的工作量),server 放在 aws 上有每月的 cost,数据存储和备份也有 cost,然后还有 devOps 的维护成本(假设每月 6 个小时花在上面),如果和其它工具集成,可能还有额外的使用成本(比如构建各种 dashboard),等等。
如果以一个年薪 $150k 的 devOps 来算(公司为之付出的所有支出再乘个 1.2 的系数,就是 $180k 了),初始开发成本 15 k / 4 = 3.8 k,平摊到第一年每月 $300,每月 aws bill 初期大概 $600(c5.2xlarge * 2 + disk),每月 devOps 维护成本 15k / 160 * 6 = $560,算下来第一年的 TCO 接近每月 $1500。$1500 是什么概念?datadog 监控每台服务器 $15/host/month,可以应付 100 台服务器的监控。当你有 100 台服务器的大量 metrics 需要监控时,你的 on-premise 部署的 grafana / influxdb 可能又不够用,需要更多地计算和存储资源和更多 devOps 时间来处理,这又应对着更多地 cost。
所以,粗略算一下,如果你管理的服务器小于 150 台时,甚至,小于 200 台时,自建监控平台的 CPR 可能都并不合算。
R2:如果花得起时间打地基,就一定要先打地基
互联网软件的开发是环环相扣的。暴露给用户的部分,只是冰山在水面的一角。你要把这冰山这一角露出来,可以往海中扔一个冰块,也可以从底向上一点点构建冰山。虽然用户看见的东西大体一样,但冰块会慢慢融化,冰山则异常坚挺。很多时候,我们很快地搭出一个服务,享受鲜花和掌声之后,要问问自己:这是否是个空中楼阁?我(和团队)能够在这上面继续构建更多功能,还是很快就要推倒重来?
老子在谈「善为道者」有个精彩的反问:孰能浊以静之徐清?孰能安以静之徐生?我们的工作大部分时间里都像一杯混着泥沙的浊水,需要我们内心「平」「静」,耐心地从纷繁复杂,浑浊不堪中理清头绪,「致虚极、守静笃」。
打地基的工作看上去拖累整个工作进程,实际上它是一个厚积薄发的 enabler。你可以花十分钟在 aws console 上点出一组资源(VPC,ec2,security groups,ebs,ALB,…),来提供某个服务,然而,同样的事情你可能需要一而再,再而三地重复。可是,如果花时间为此做一个自动化工具,可能需要一个非常熟练和精通 terraform 的工程师一周的时间。做还是不做,这是个问题。
我的答案是只要不是火烧眉毛,就一定要做这些基础的自动化的工作,效率渐渐提升还是其次,重要的是这样大大降低了团队犯错的机会。人类是宇宙间最不擅长做机械动作的物种,同一个字抄十遍还形态各异,一个有十几道工序的 wizard 上重复十遍(所以泰勒强调流水线上标准化的「科学管理」),出错的概率会大增。所以我们要生产和使用工具,通过这些基础的工作来降低犯错的概率。当然,在构建前,要用 R1 的原则指导自己,选用最合适的工具来构建这些基础工具。
在 arcblock 这一个月,我的 70% 的代码时间都投入到了 infra 的构建,写了几千行的 terraform,ansible 和 packer 的代码,就是这个道理。
举个例子。我们都知道「安全性」和「易用性」往往是矛盾的。当我们追求极致的安全性时,必然会带来极大的不方便。比如谁都知道密码要定期更新,但想想你生产环境的数据库的密码,有多久没有替换了?谁都知道 MFA(两步验证)能最大程度保证重要功能的安全,但将其应用在 AWS access key 上的又有几人?不是我们不想用,而是极度地不方便让我们选择忽视 security best practices。
这样的「地基」如果不能一开始就打造好,日后会带来无穷无尽的麻烦。所以我们要通过工具来最大程度弥补因为追求安全性而丧失的易用性:
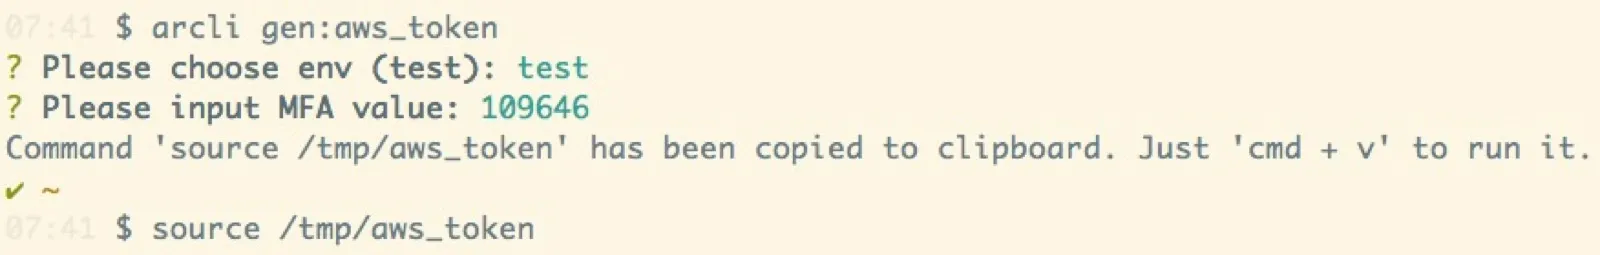
这个命令会简化 MFA 带来的痛楚,工程师只需运行一次,其 shell 环境里就保存了两步验证后生成的临时的 access key 和 session token,一天内便可以畅行无阻地使用 AWS API 的能力。
?做个 arcli ssh:ec2 来自动从线上寻找
我们有了自己的 VPN server,可以让员工 dial in 到受保护的 cloud 里工作(比如访问 private services);我们有 bastion server,以及相关的工具(未来会有一个 arcli ssh:ec2 来自动发现和登入在私有网络中的机器)在 ssh 的安全性和便利性之间平衡;我们有一系列 ansible + packer 的脚本,让常用的服务,如 nginx,elixir-service,consul 等 bake 成一个个 AMI,随时待命。
最近花了两天的时间做了一个 ethereum 的 indexer,其中一天半我都在写一个 DSL,能够从 yml 里读出 configuration,生成相应的代码,
我们做事情,要注意不要忙乱而失去分寸。
子也曾经曰过:无欲速,无见小利。
R3:少即是多
再举一个例子。我们在处理 Ethereum 数据时,要做做各种 transformation,在源数据和目标数据间进行 mapping。我们可以一行行写代码来定义这种 mapping,但更好的做法是
R4:数据即价值,无论什么时候都要
Rich Hickey 说(妈的这句话我引用了无数次了):You have to have at least 2 solutions to make trade-off。
想象一下 F1 比赛的场景 —— 车手进站的策略
少则多,多则惑
大器晚成
不知常妄作凶
致虚极,守静笃。孰能浊以静之徐清,孰能安以动之徐生 、最近在读南怀瑾的《老子他说》,让我印象深刻的就是他对这两句话的解释。我本人认为这两句话可以当做口诀使用,就像佛家的偈子,在心烦的时候可以念念。
“致虚极、守静笃。”是道家提倡的一种最高境界。道家认为人应当“虚”,也就是对任何事都不要有成见,就像一个空的容器一样,只有时刻保持空的虚的状态,才能用来装东西,才能发挥大作用。但普通人哪里能做到呢?我们总是习惯地用已有的知识排斥或者忽略别的观点,只有修炼到极致的人,也就是从心底里认为自己欠缺的人才有可能吸纳更多的知识,许多大学问家会表现的非常谦虚,这就是一种致虚极的境界吧。下一个高深的境界就是“静”,不急不躁,不卑不亢地对待任何事,也许一个人“虚”到极点,就能自然地静下心来处理任何事:在学问方面,用谦虚的态度静静地听别人的观点,平静地看待荣辱得失等。当我们心浮气躁时,当我们沮丧时,问问自己,我是满的还是虚的?在某项专业知识上已经是牛人了吗?我真的比谁谁谁了不起吗?试着念念这句口诀,品味一下其中的境界,也许有用。
“孰能浊以静之徐清、孰能安以动之徐生。”这句话充满了积极向上的意义,同时具备很强的思辨力量。老子心目中的处事态度是“浊”,不提倡举世皆浊我独清的态度,而是提倡“混兮其若浊”、“和其光,同其尘”,也就是说不要认为自己了不起,每个人的行为都有其道理,我们应该理解他们和接纳他们,如他们一样,表面看起来有点浑浑噩噩,但内心要“静”,就像一杯含有沙子的黄河水,只有在安静的状态下,才能慢慢变清,也就是脑子里从纷繁复杂的“浊”中理清头绪,变得清醒。后一句,非常积极:只有静静地弄清楚了是不够的,还需要动起来,反馈社会和他人,发挥自己积极的作用。但是,不要乱动,首先要安,即心态要平稳,如果慌里慌张地去做,那自己会变成真的浊,搞不清楚状况了,其次要“徐生”,就是慢慢来,太着急地去做,往往不成。
老子的“静”“虚”与佛家的“空”有异曲同工之妙,值得好好体会。
重新定义软工
我曾经在「」一文中提到,不要用你所使用的语言来限制你的能力 —— 程序员总会称自己是 Java 程序员,Elixir 程序员,但你听过哪个医生叫自己是四环素医生的?
我也曾经在很多场合下讲过,一个程序员,要有端到端的开发能力 —— 从一个构想起,可以一路做到发布上线,以及线上的监控,预警和事后的分析。如果把会写代码比作国小毕业,那么,当你构建了端到端的开发能力后,你便可以称自己为研究生了 —— 你可以不依赖于别人替你铺路搭桥,甚至不需要别人告诉你该做什么,因为,你已经能够自己发现问题,而不单单去解决问题。
我谈论这些的时候,出发点是 1) 要打造开发能力的矩阵,而不是局限在一点 2) 要尽可能缩短整个过程的 feedback loop。
打造开发能力矩阵这一点,我相信绝大多数人都会认同;而缩短整个过程的 feedback loop,则不是那么显而易见。对于脑力劳动者,如果我们把一颗颗脑瓜看成一个个线程,她们的时间和能力的最大的浪费就在于同步(synchronize)的过程。同步扼杀效率,同时也扼杀创造力。当你完成了一个功能的开发后,如果不得不把部署交给 devOps,你们之间需要有沟通,这是一个典型的「停等」的过程,
然而,我并未清晰地描绘 why —— 为什么打造开发能力的 matrix 很重要?为什么要通过端到端的构建能力来缩短 feedback loop?以及为什么更短的 feedback loop 很重要?
「停等」的过程,或者说
—— 如果把人看成一个有版本的产品,我的 feedback loop 是一周,你的是三个月,那么,我一年版本进化 52 次,而你只有 4 次,成长的速度高下立判。