北美互联网哀鸿遍野,因为号称 99.9% 可用性的 AWS S3 挂了
事件回顾
美西太平洋时间早上 10 点(北京时间凌晨 2 点),AWS S3 开始出现异常。很多创业公司的技术人员发现他们的服务无法正常上传或者下载文件。有人在 hacker news 上问:Is S3 down? 然后迅速得到大伙的确认。
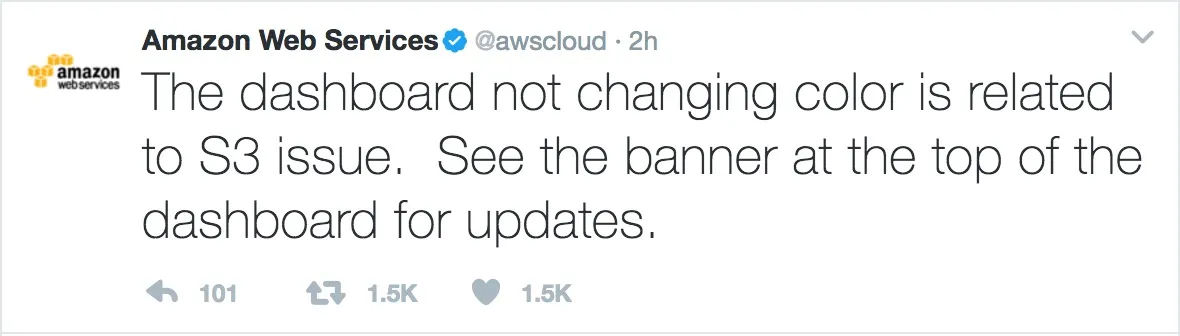
然而,AWS 自己的 status page (https://status.aws.amazon.com) 却后知后觉,放眼望去,一片让人喜滋滋的绿油油。就在大伙儿以为自己神经过敏,一切都是虚妄的猜测时,AWS 的工程师惊悚地发现,由于这个页面依赖于 S3,所以它实际上也挂了,于是赶紧放了个 banner 上去说明状况,昭告天下绿油油是假象:
11:35am,经过一番努力,这个页面总算显示正常的状态了:
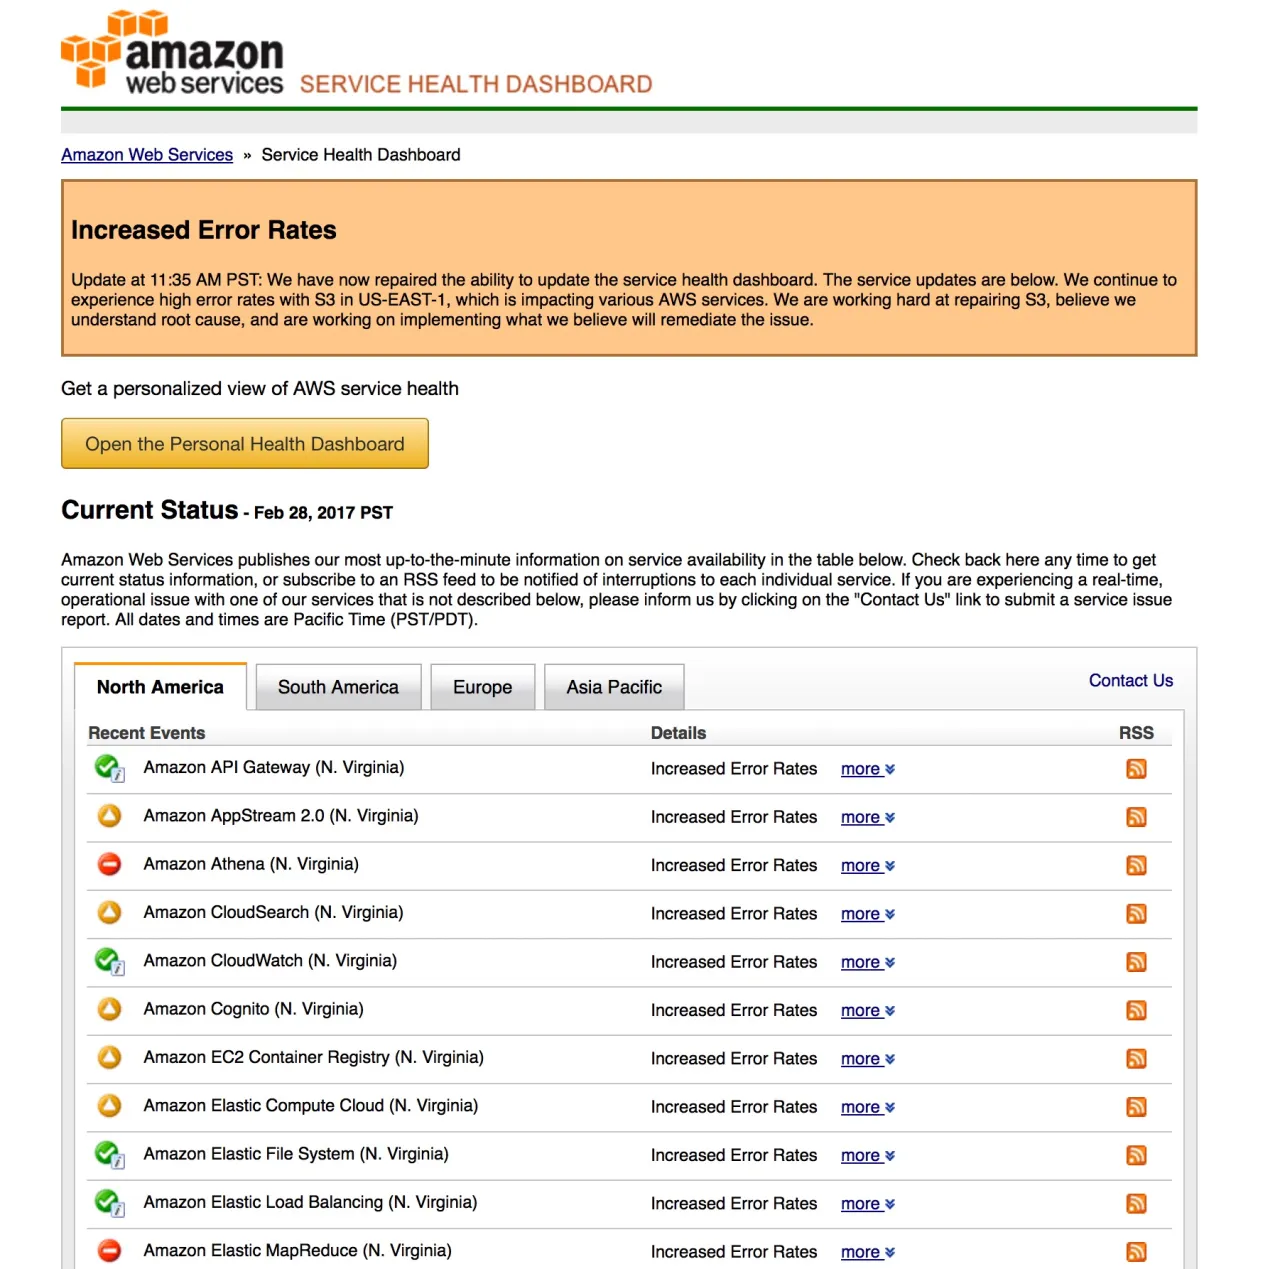
可以看到,重灾区是 North Virginia 的 S3。由于 S3 不工作,那些高度依赖 S3 的服务,比如 Elastic Map Reduce(需要 S3 存储中间过程和结果),以及去年 re:invent 刚发布的 Athena(查询的数据要放在 S3 上),也完全挂掉。依赖 S3 不那么重的服务,状态也不是太好。
S3 是 AWS 最早发布的云服务,simple storage service,解决存储的问题。存储是任何互联网服务的基石 —— 只要有大的数据对象,无论是图片,视频还是文本,我们都需要一个合适的存储方案保存它们。在没有云的日子里,这些内容要么存储在无比昂贵的 SAN (Storage Area Network) 中,要么存储在大量 PC 服务器的磁盘阵列中,通过一些特殊的文件系统,如 HDFS 来访问。为了维护这些数据的持久性和可用性,互联网公司需要在这样的基础设施上花费巨大的人力物力,无法集中所有的工程能力处理业务。当 S3 和类似 S3 的服务诞生后,对于很多初创的互联网公司,简直是久旱逢甘霖,99.99999% 的持久性(durability),和 99.9% 的可用性(availability)爽的不能再爽,于是纷纷把自个的存储架构布在了 S3 上。时至今日,使用 S3 的网站,已经多达 148, 213 个(数据来自 techrunch)。
所以,当今早 S3(主要是 North Virginia)宕机时,整个北美的互联网呈现一片哀魂遍野的景象。
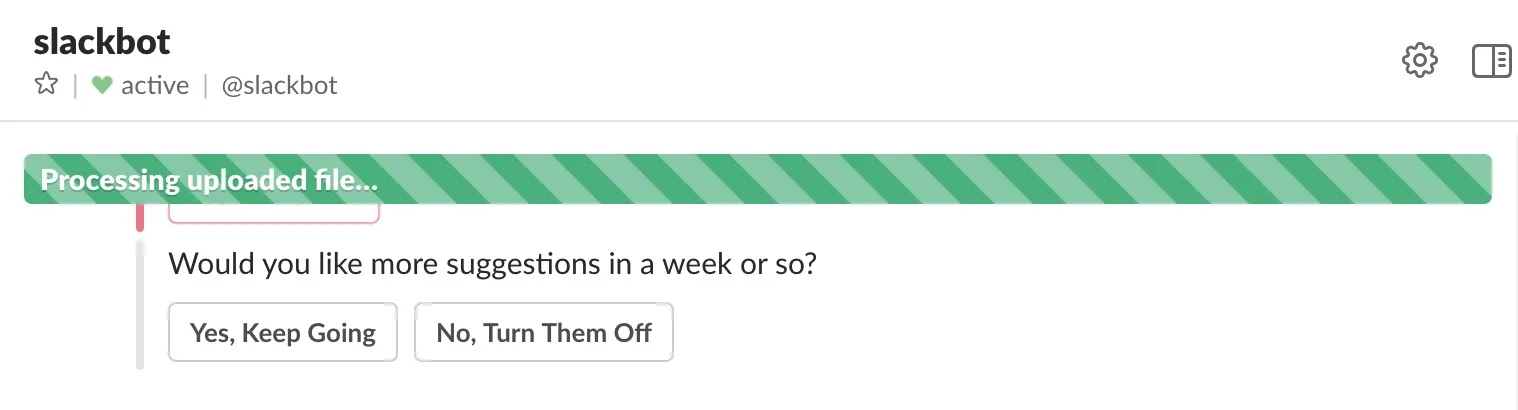
Slack 无法上传文件,进度条永远在走:
Trello 表示老子都被收购了,休息,休息一会也无妨:
收购了 Trello 的 Atlassian 也不遑多让,文案好有喜感(我都怀疑他们的工程师发现问题了么):
最近 VC 的宠儿 giffy,表面上一切正常(CDN 扛起了 gif 的下载),但如果你要上传 gif,对不起,偶们也不知道发生了神马事情:
至于高冷的 quora,干脆连个暖心的页面都不给,直接说,老子不玩了:
。。。
照理来说像 quora 这样的服务,面向用户阅读的部分本不该高度依赖 S3,要挂也不该全站挂,顶多是挂用户撰写答案的部分,不知道为何整的这么彻底。
我们看看当问题出现时,一个普通的 S3 GET 返回什么:
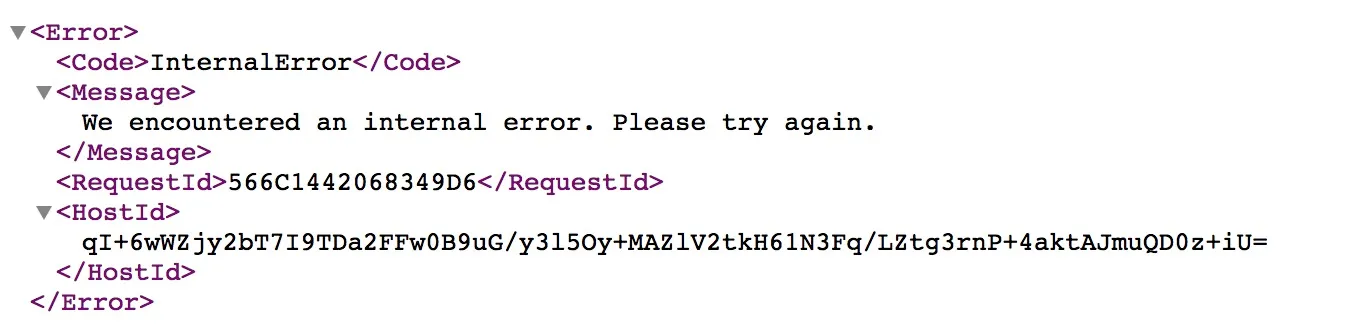
AWS 直接告诉你,Internal Error 了。从 error handling 的角度,我们在写代码的时候都应该捕捉这个异常,然后做合适的错误处理。很遗憾的是,S3 这样的服务是如此基础,就像互联网的水和电一样,大家默认为它永远不会出错。因此,好多工程师干脆不做错误处理,像 slack 那样,任由进度条一直傻乎乎地跑;或者,让错误一路冒泡,知道把整个服务挂掉了事,像 quora / trello 那样;更好的处理方法是,捕捉到异常,让错误只局限在特定的页面,如:atlassian / giffy。
使用 S3 的用户如何自保?
类似的事情发生在任何公司上都是不幸的,尤其是给客户以 SLA 保障的 SAAS 公司。大家能做得就是:
- 当云服务商的宕机发生时,尽量控制它影响面。像 trello 这样连 landing page 都一并挂掉实在不可取;而像 quora 这样的服务,可以准备一个静态化的镜像,一旦出问题,起码让读者有的读。
- 尽可能地把动态内容缓存起来,甚至静态化。redis cache,nginx cache,CDN 都是把内容缓存甚至静态化的一些手段。尽管多级缓存维护起来是个麻烦,但当底层服务出现问题时,它们就是难得的战略缓冲区。cache 为你争取的半个小时到几个小时可能能让你撑过最要命的时刻(这次 S3 宕机前后大概 4 小时),相对从容得寻找解决方案,紧急发布新的页面,或者迁移服务,把损失降到最低。否则,只能像这次事件中的诸多公司一样,听天由命,双手合十祈祷 aws 的工程师给力些解决问题。
- 使用 simian army 在平日里操练系统的容错性。这个适合大一些的,工程团队有余力的公司。netflix 重度使用 aws,却在历次 aws 的宕机中毫发无损,是因为他们之前也深深地被云的「不稳定性」刺痛过。他们的 chaos monkey(之后发展为 simian army)服务,会随时随地模拟各种宕机情况,扰乱生产环境。比如说对于此次事件的演练,你可以这样配置:
simianarmy.chaos.fails3.enabled = true。这样,这群讨厌的猴子就会在你不知情的情况下随机把你的服务器的/etc/hosts改掉,让所有的 S3 API 不可用,这样你就可以体验平时很难遇到的场景,进而找到相应的对策(注意:第一次请在 staging 环境下试用,否则老板把你开了不要赖程序君)。
如果 AWS 真的发生大规模宕机,而你又没有采取任何措施,天也不一定就塌下来了。此时此刻,你的投资人,你的客户,你的合作伙伴也许都忙着解决他们各自的宕机问题呢,hacker news 上(https://news.ycombinator.com/item?id=13755673)有个笑话这么说:
Why do we host on AWS?
Because if it goes down then our customers are so busy worried about themselves being down that they don’t even notice that we’re down!
看,这就是 CIO 们的狡黠之处(自建的出了问题都得自己擦屁股)。
如何利用这样的宕机机会?
Google 的工程师忙不迭地过来补刀加教育用户:
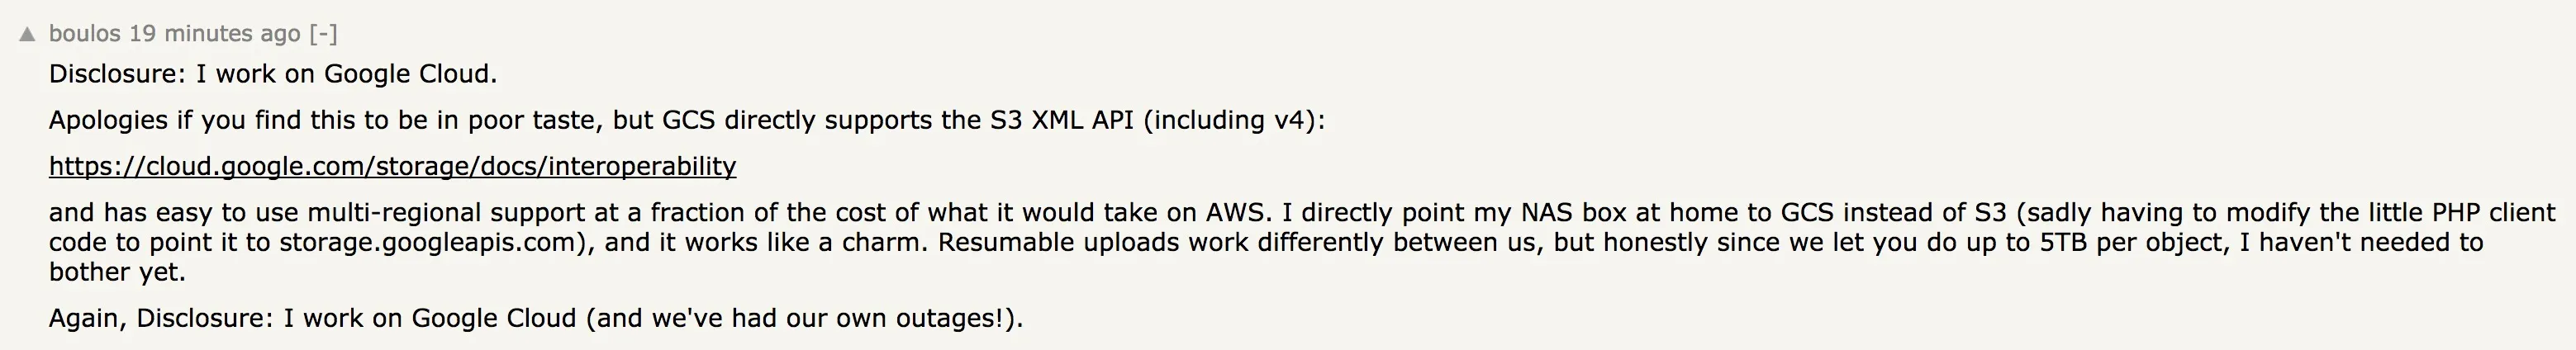
你看,这个社会就是这么群狼环饲。你别说不努力了,你努力着,但只要摔上一跤,就有狼过来蹭肉吃。对于甲方来说,狼越多选择越多,开心都来不及;作为乙方,则欲哭无泪。只是,每家公司,甚至每个人,都在不同的上下文中扮演不同的角色,一会是甲方,一会是乙方。
什么?你问 Tubi TV 宕没宕机?虽然我们有我们的烦恼,但是托 CDN 的福,在过去的几个小时,我们好好的。


